上下文工程(Context Engineering) 是什么?和 Prompt Engineering 有什么区别?
调用模型时,我们通常会同时发送用户问题、系统指令和一些参考资料。对 Agent 来说,还要加上工具定义、工具返回结果,以及前几轮留下的任务状态。这些内容共同组成了本轮上下文。
上下文工程(Context Engineering)就是管理这些信息的选择、组织和更新。 例如,订单已经退款,后续调用就不该继续把“待退款”当作当前状态;历史对话压缩成摘要后,用户的只读授权也不能随之消失。
同样的 Agent,为什么表现差这么多?
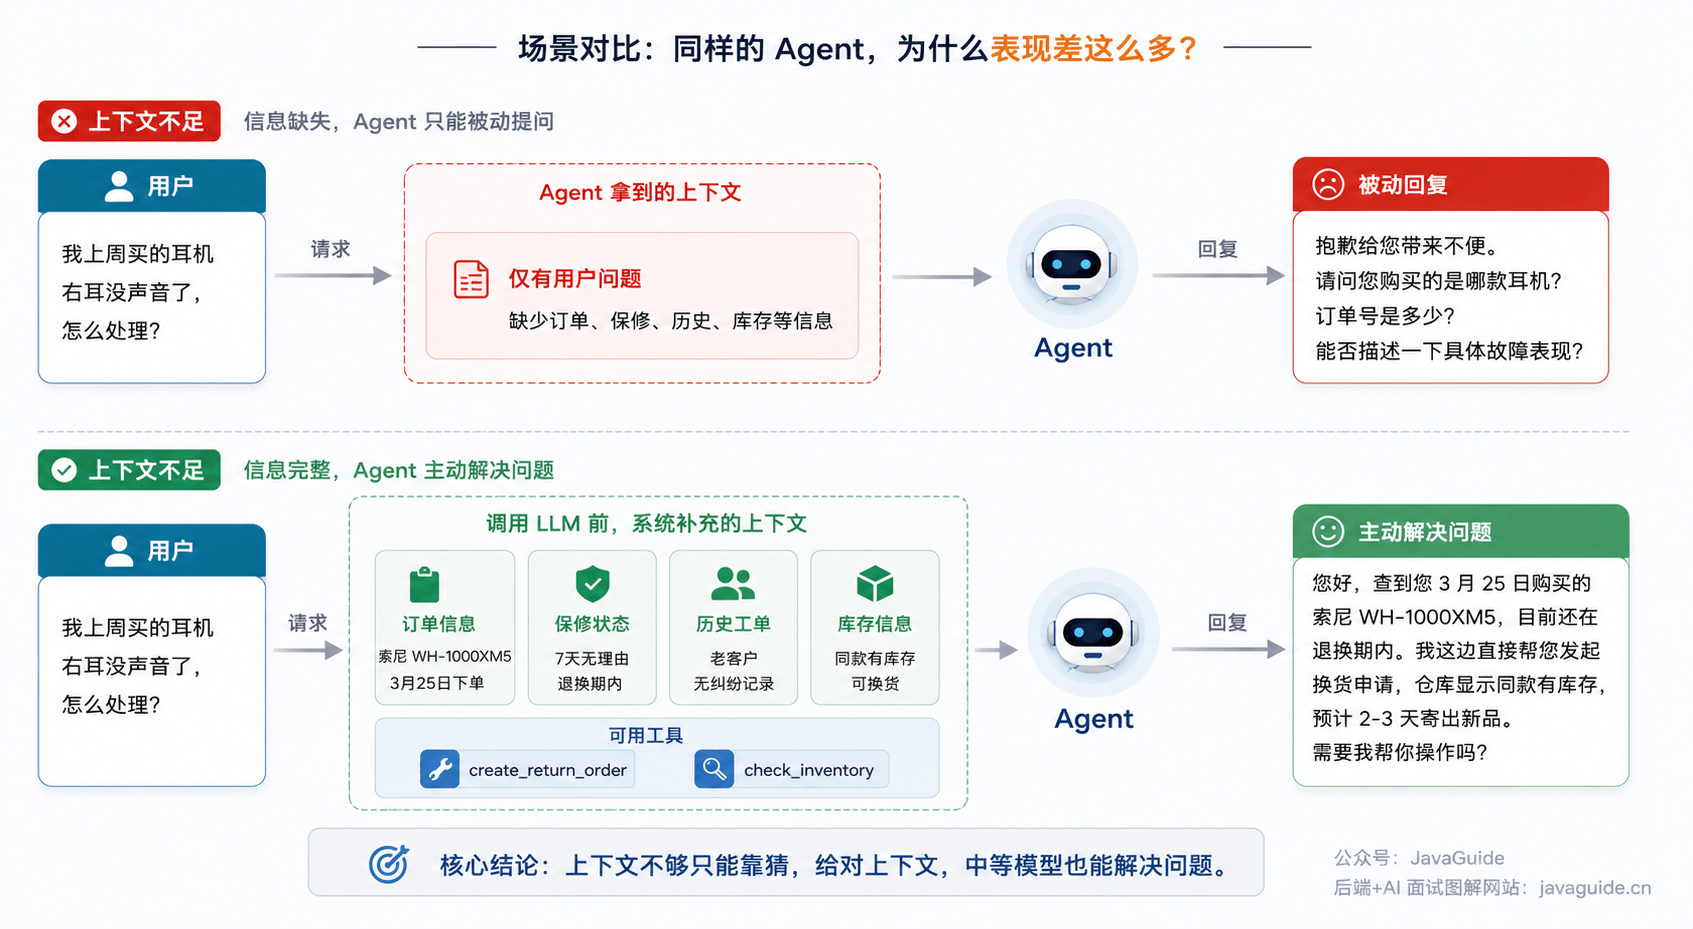
假设我们给电商系统接了一个售后 Agent。
用户问:“我上周买的耳机右耳没声音了,怎么处理?”
如果请求中只有这句话,模型并不知道用户买了哪款耳机、什么时候签收,只能继续询问订单信息。这种追问是合理的,不能要求模型猜出数据库里的订单。
但用户已经登录并选中了订单时,应用可以在校验权限后读取这些数据,省去重复询问。
这一次,送给模型的材料包括:
- 用户有权查看的订单:索尼 WH-1000XM5,3 月 25 日下单,以及对应的签收时间。
- 业务服务根据商品、时间和适用政策核验的结果:这笔示例订单可以申请换货。
check_inventory返回的同款商品库存。- 可用的
create_return_order工具,以及调用前必须取得用户确认的要求。
模型据此可以回答:“查到您 3 月 25 日购买的耳机,这笔订单可以申请换货,同款目前有库存。是否需要发起换货申请?”用户确认后,应用再按业务流程执行工具;没有物流依据时,也不应额外承诺发货时间。
这里改变的是模型收到的信息。订单归属和换货资格由业务服务校验,模型负责结合结果回答用户。保修期、退换期限是不同的业务条件,不能查到“仍在保修期”就直接判定可以退换。
有了这些材料,模型才知道应该按哪笔订单、哪项政策回答。至于是否选对工具、后端是否完成权限检查、换货申请是否创建成功,还要沿着调用过程逐项检查。
Context Engineering 到底在做什么?
和 Prompt Engineering 差别
Tobi Lutke 将 Context Engineering 概括为:
the art of providing all the context for the task to be plausibly solvable by the LLM
这里的 context 包括当前任务所需的信息。拿售后助手来说,模型训练时可以学到退换货的通用知识,却无法知道用户刚刚付款的订单状态。应用需要查询这笔订单,再把结果交给模型。
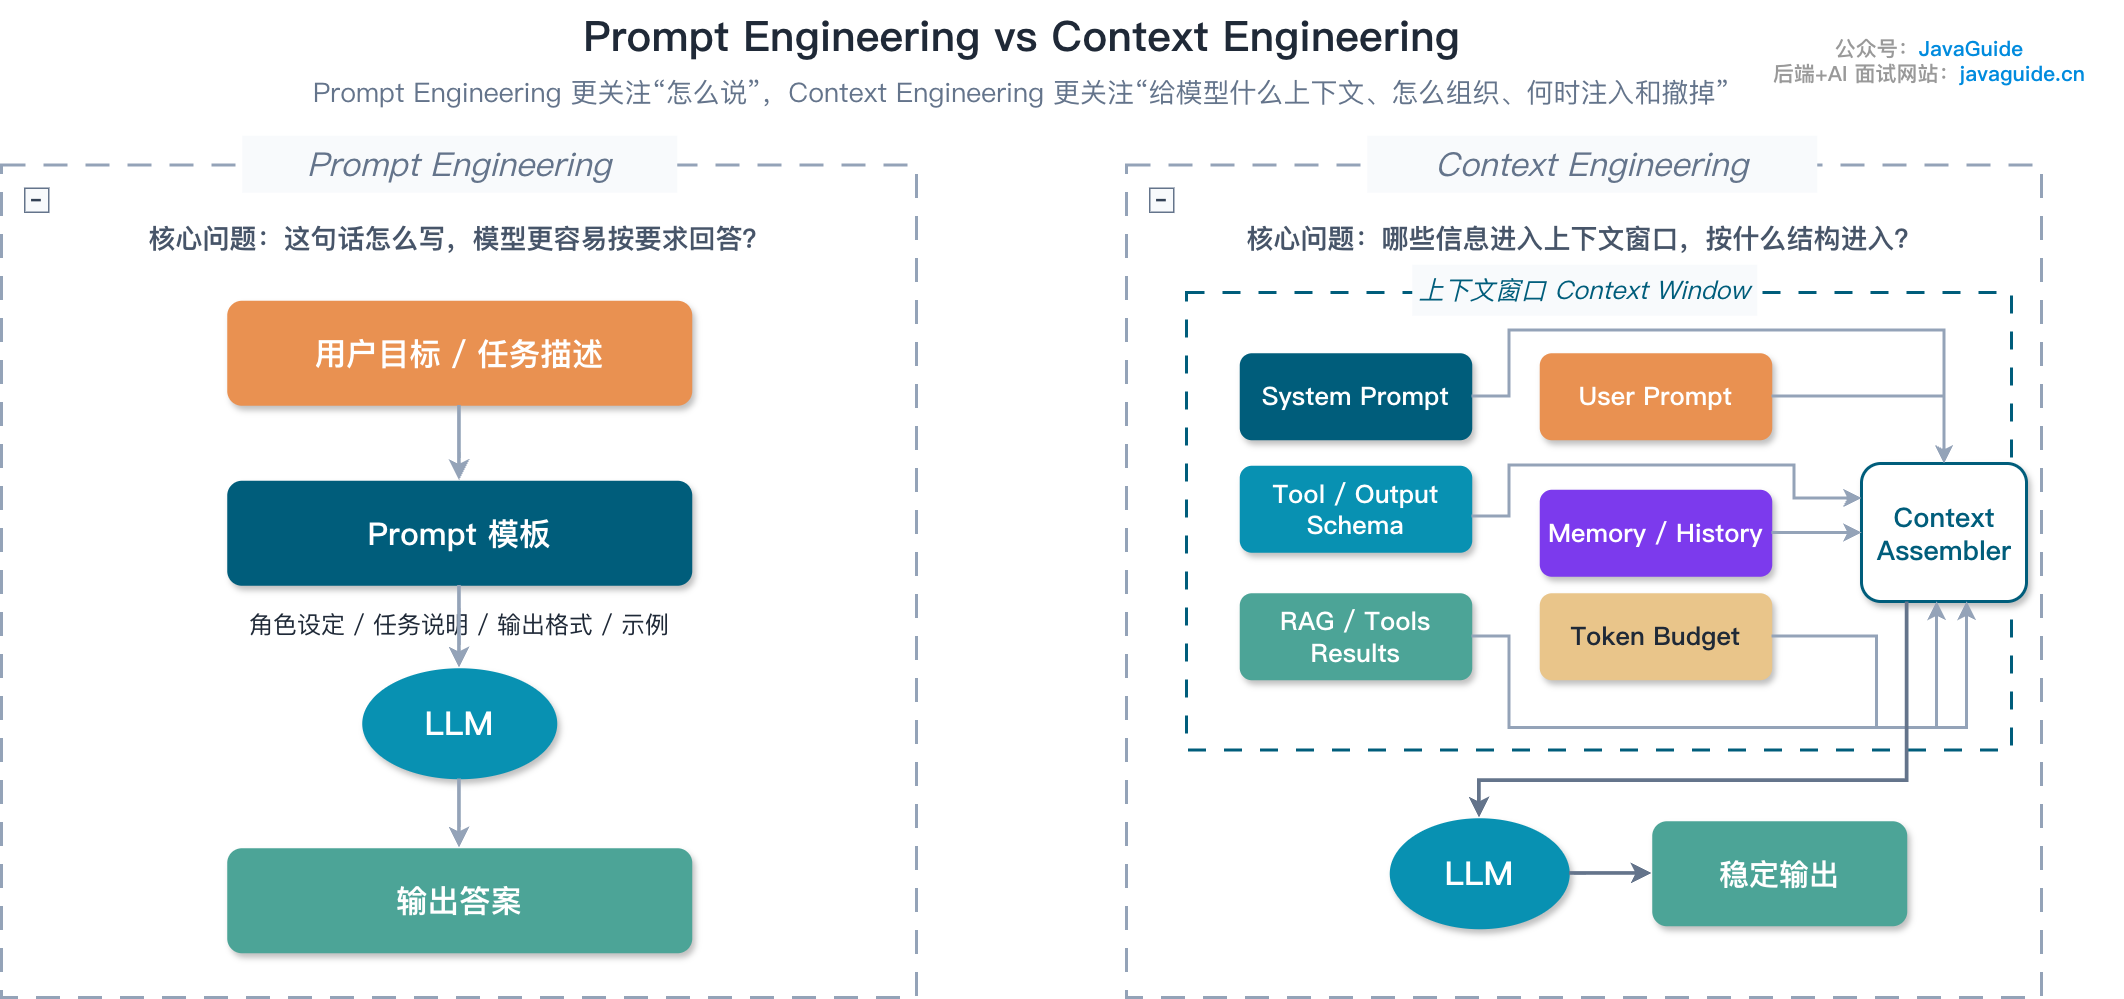
两者的区别可以继续用这个例子说明:
- Prompt Engineering:把“回答售后问题”改为更明确的指令,例如要求依据查询结果回答、缺少签收时间时追问。
- Context Engineering:决定从哪里读取签收时间、查到哪版政策、提供哪些工具,以及订单状态变化后怎样更新历史信息。Prompt 的编写也是其中的一部分。
Anthropic 官方博客用下图对比了这两个层面:
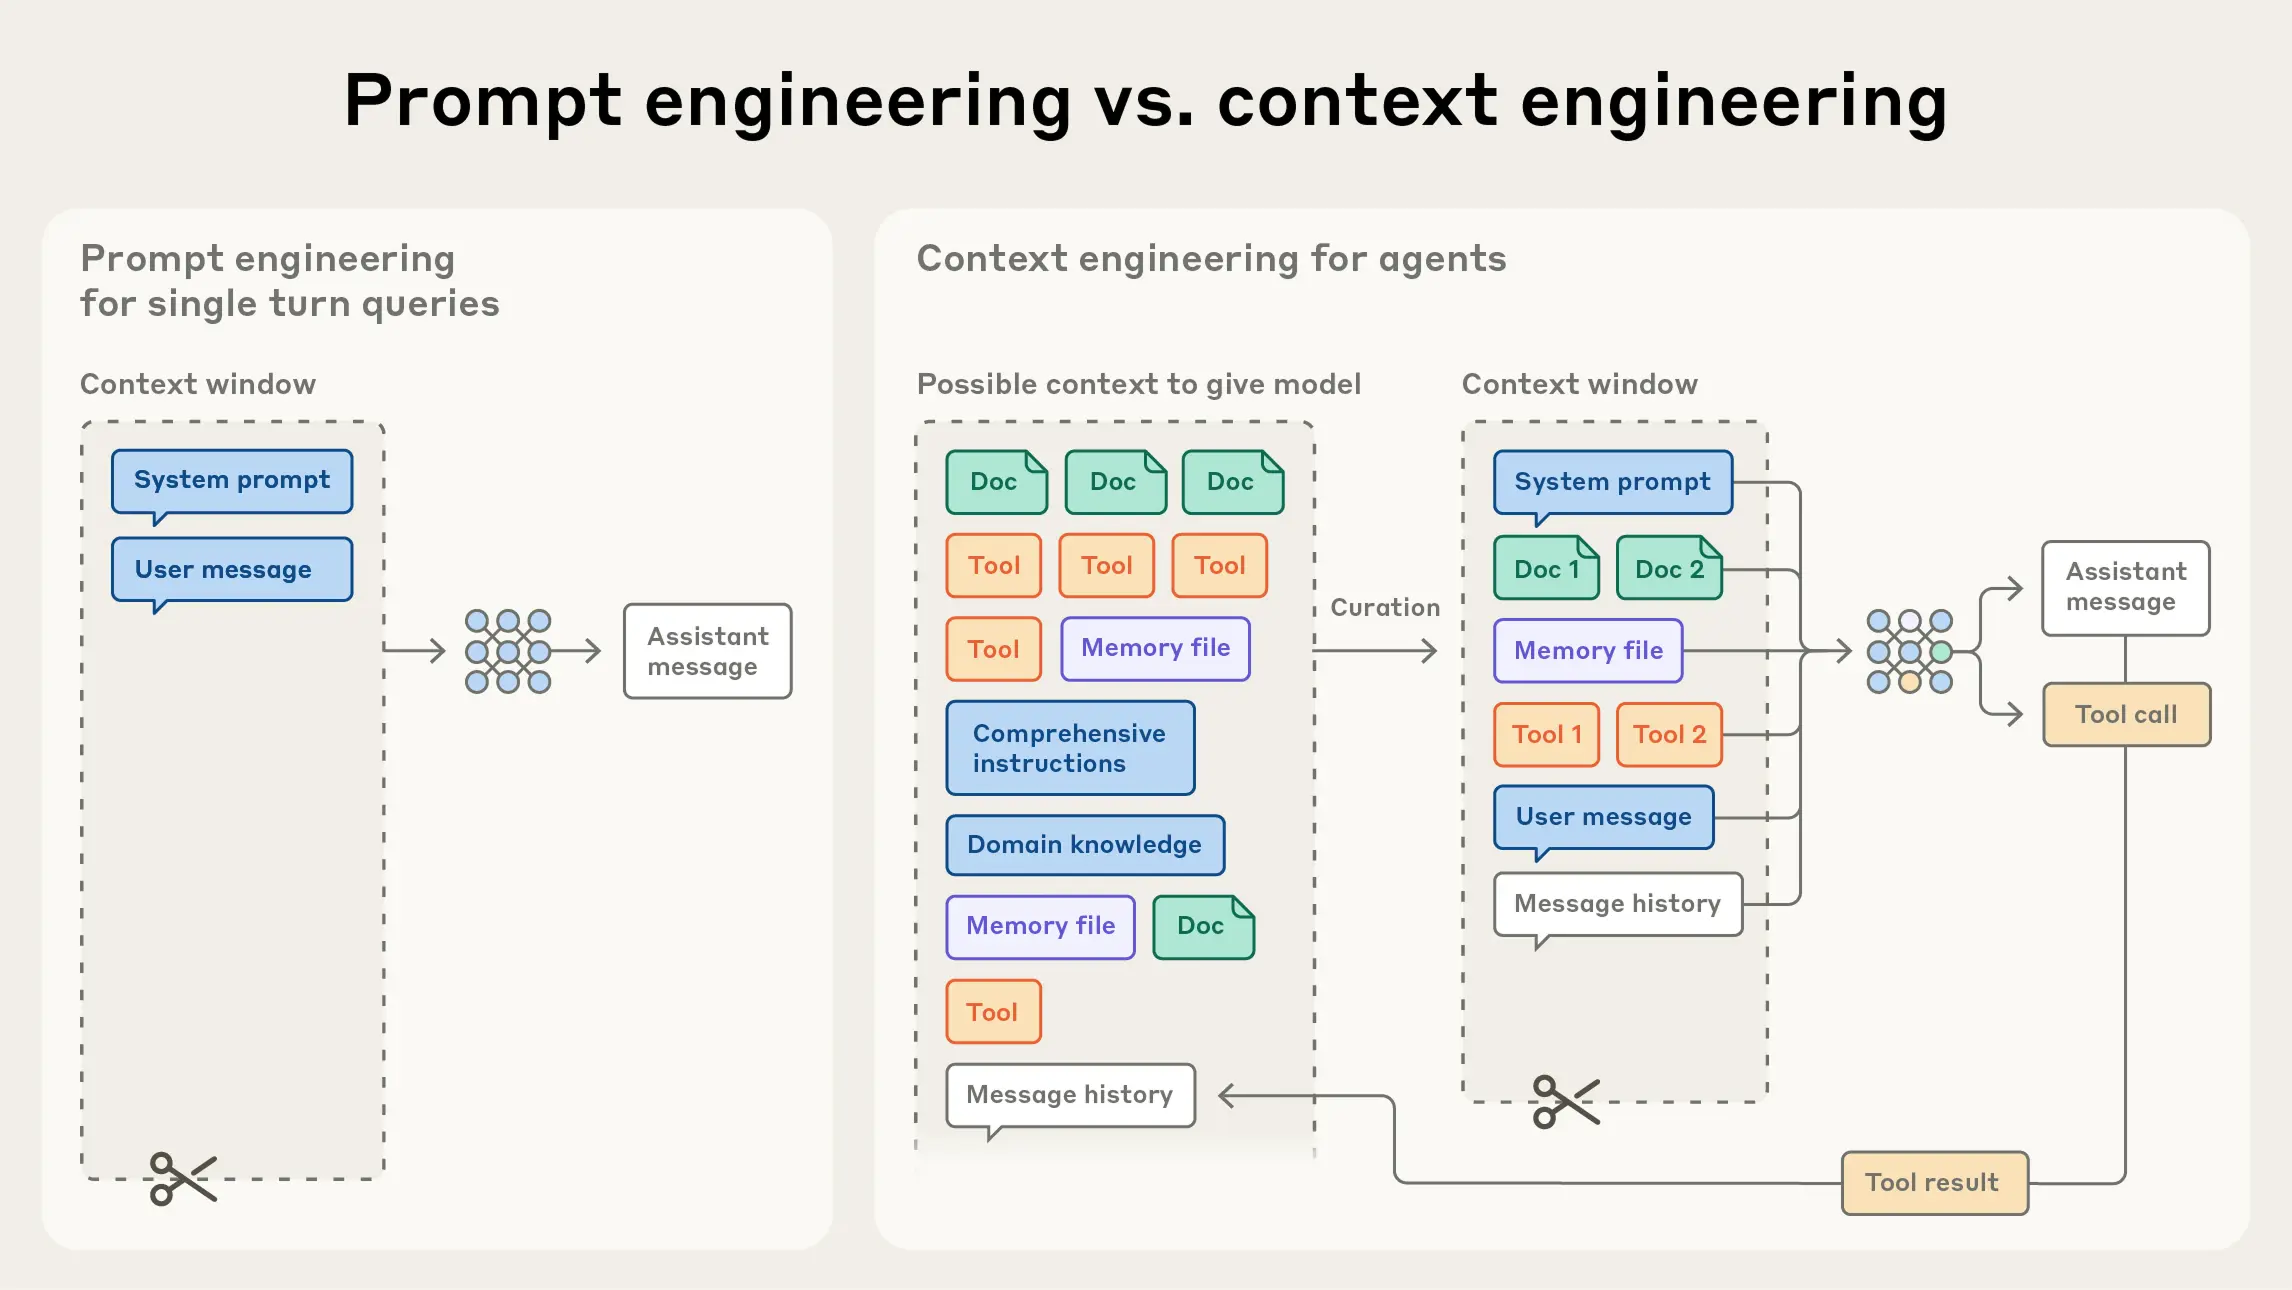
写好了指令,还需要检查请求中是否真的带上了相关材料。比如指令要求“按当前政策回答”,实际检索到的却是旧版政策,继续调整措辞并不能补上正确资料。

我个人更喜欢另一个类比:Context Engineering 就是 LLM 的内存管理。
上下文窗口就是一块有限内存。Context Engineering 管的是这块内存里装什么、换出什么、什么时候读、什么时候写。窗口满了就得淘汰内容,这跟操作系统里的页面置换是一个思路,比如 LRU、优先级策略之类的。后面讲到 Token 降级的时候,其实也是在处理这个问题。
它具体管哪些东西
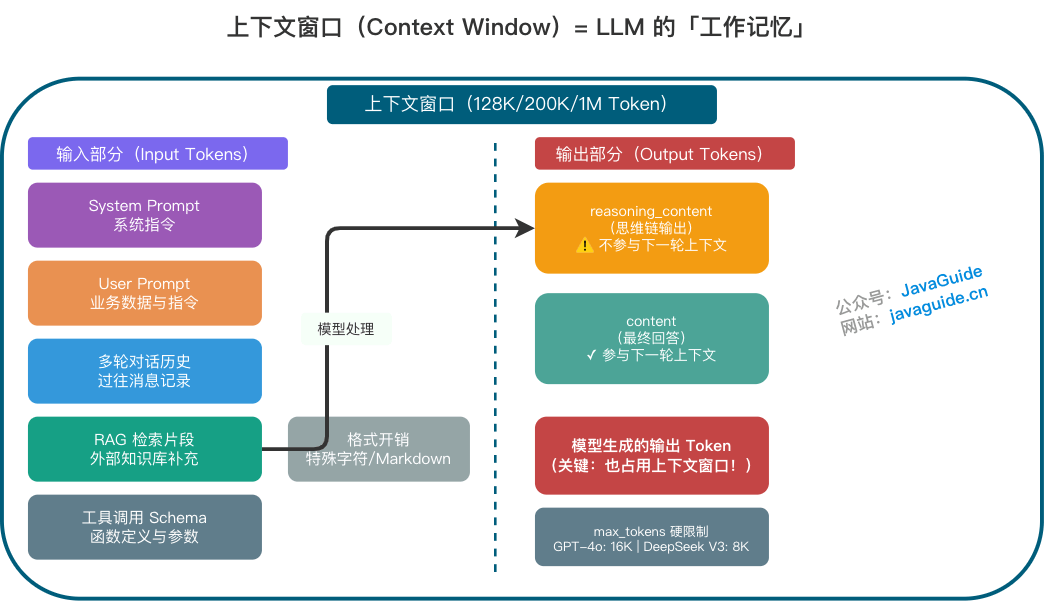
拆开看的话,Context Engineering 至少管这么几块。
System Prompt 是 API 消息里的高优先级指令。.cursor/rules、.claude/rules、AGENTS.md 等文件是宿主程序读取的规则来源,宿主会按自己的加载规则把其中一部分转换成模型上下文;它们和 API 角色意义上的 System Prompt 不是同一个概念。Cursor 早期使用的 .cursorrules 已属于旧版形式,新项目应使用 .cursor/rules。
User Prompt 是用户输入的业务数据和指令。看起来简单,但真实项目里经常会混着自然语言、业务字段、历史状态、附件内容,处理不好就会把上下文搞脏。
Memory 这块分短期和长期。短期记忆可以保留当前 Session 的最近几轮消息;窗口之外仍需保留的信息,可以存入文件、KV、关系库、图数据库或向量检索层。选哪种存储取决于读取方式。例如按订单号读取确定状态,和根据语义查找相似历史问题,就不必使用同一套方案。保存之后,还要处理更新、过期和重新读取。
RAG 负责从外部资料中查找证据,再把相关片段加入请求。Tools 则让模型知道可以调用哪些操作、参数怎样填写。调用后得到的结果也会影响下一轮判断,因此工具定义和返回结果都需要管理。RAG 解决的是上下文来源中的一部分问题。
JSON Schema 用于描述字段和结构,Function Calling 还需要提供工具的名称、参数等定义。模型能否按要求生成调用,与这些定义是否清楚有关。工具返回的 Observation 也不必全部保留在后续消息里:同一异常出现多次时,可以保存原始日志,在上下文中留下错误码、关键堆栈、出现时间和原文位置。
这里还容易混淆摘要与缓存。摘要会改变模型看到的内容,裁剪会移除部分内容,都可能丢信息。Context Caching 复用的是已经处理过的输入;命中后可以减少重复计算的成本或延迟,但这些输入仍占窗口容量。具体机制见 Claude Prompt Caching 文档。
上下文为什么会失效?
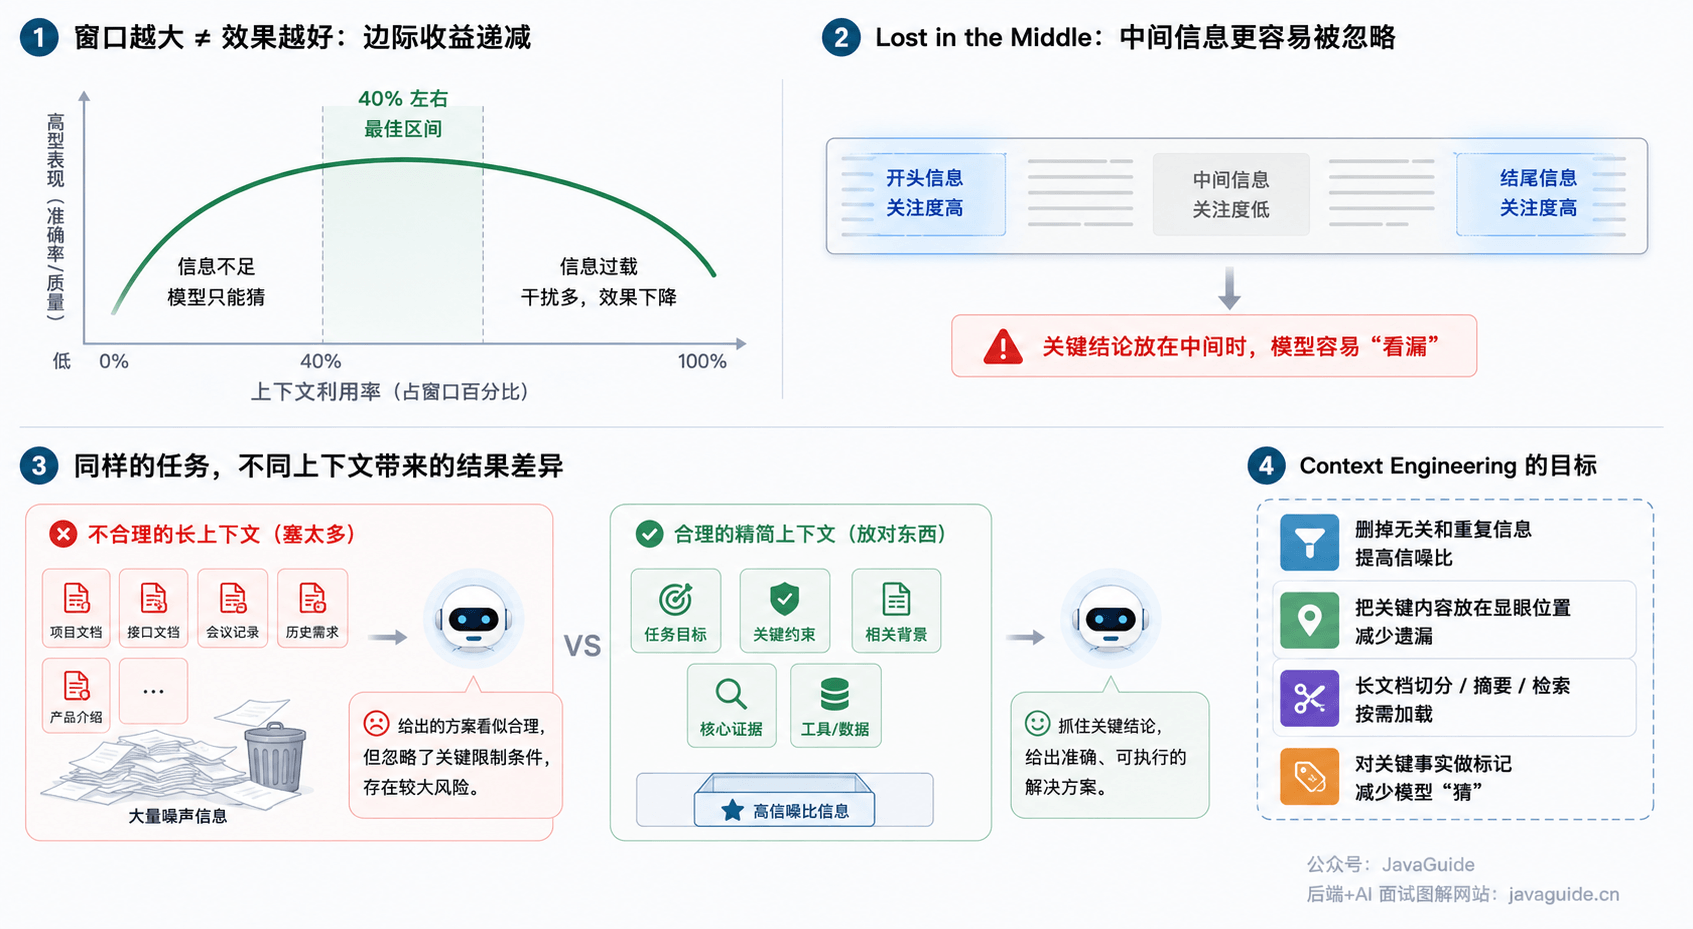
模型支持长上下文,表示它能接收相应长度的输入,不能由此推出它在这个长度下仍能准确完成所有任务。

图中的 40% 是特定任务下的经验参考,不是所有模型共有的失效点。实际测试至少要区分输入长度和证据位置:增加无关材料,与把同一条证据从开头移到中间,改变的是不同条件。
例如,要求 Agent 评估登录改造时,资料里有一句:“老用户仍依赖旧版 token 校验,不能直接切到新鉴权模块。”如果这句话夹在大量会议记录和历史需求之间,模型可能给出直接切换的方案。虽然请求包含这条约束,最终回答却没有用上它。
Context Rot 研究了输入长度变化对模型表现的影响。Chroma 的测试发现,即使在一些简单任务上,增加输入也会使模型表现变得不稳定。这个结果提示我们需要评测长上下文中的实际任务,而不能只看窗口规格。
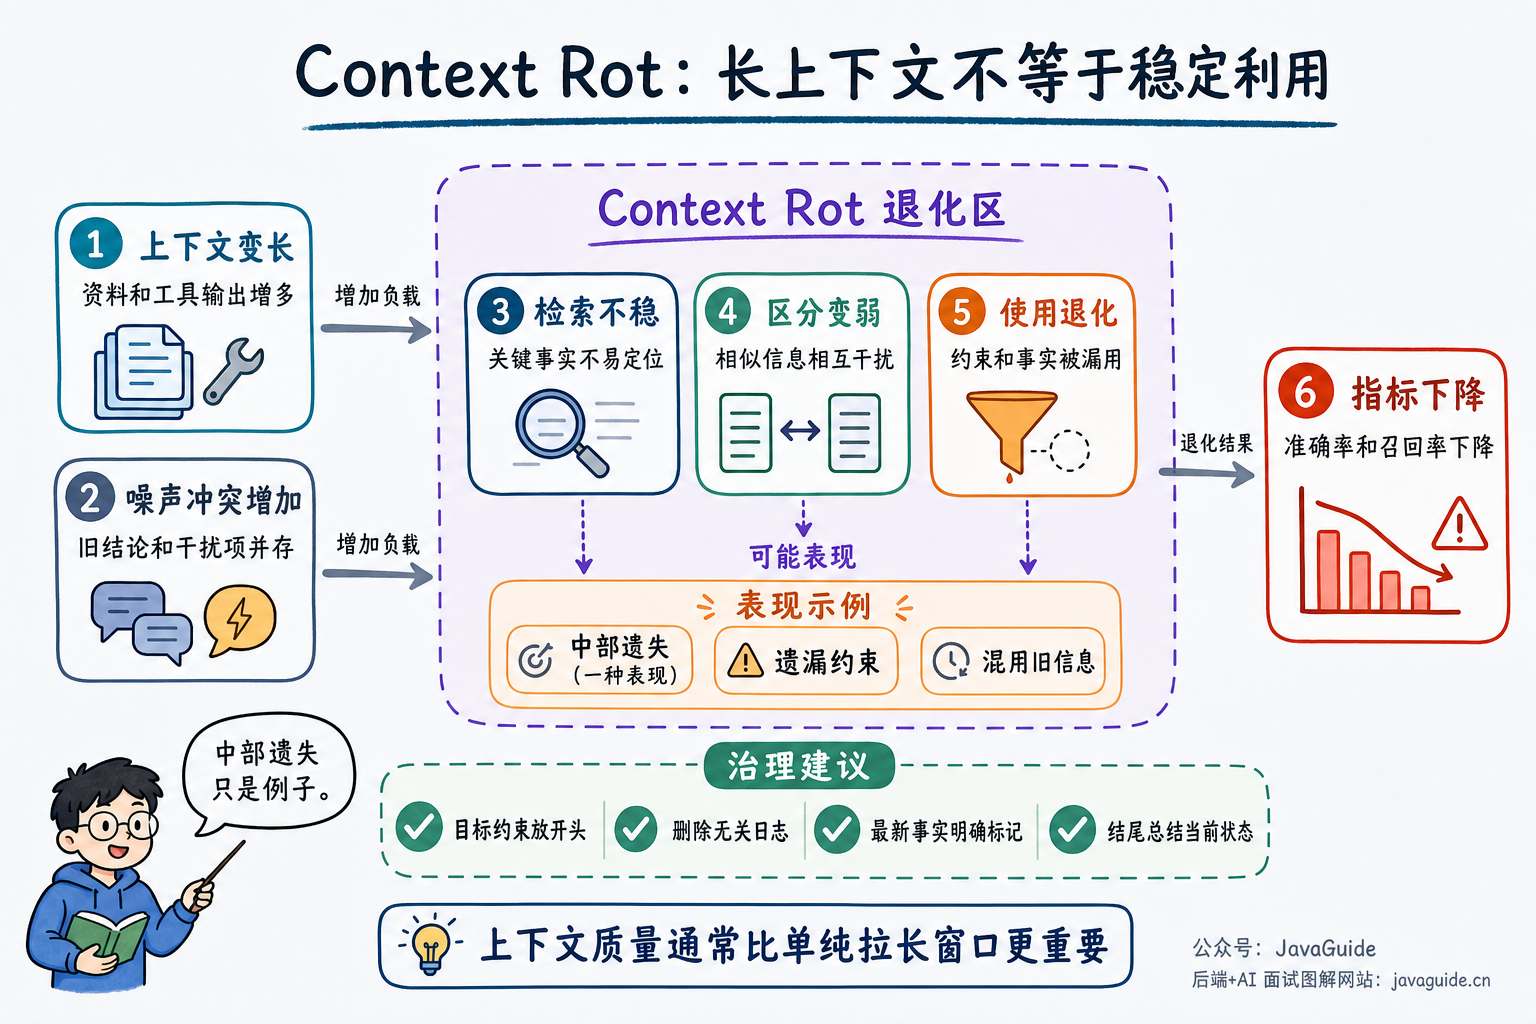
Lost in the Middle 关注证据的位置。在论文的多文档问答和键值检索实验中,相关信息放在开头或结尾时,模型往往表现更好;移到长上下文中间,表现则可能下降。这是实验中观察到的位置偏差,不意味着所有模型、所有任务都会以相同幅度退化。
从计算过程看,Transformer 的 Attention 会根据 Query 和 Key 计算权重,再对 Value 做加权聚合。这里的 Query、Key、Value 是模型中的向量,不是数据库查询语句。这个过程可以帮助模型组合上下文信息,但并不保证关键业务约束一定得到足够关注。
标准全注意力的注意力矩阵规模随序列长度平方增长,因果掩码也不会改变这一数量级。稀疏注意力、分块、缓存和压缩等技术可以在各自适用的环节降低开销。不过,计算开销与回答质量仍要分别评估,不能把复杂度直接当成 Context Rot 的原因。
输入更长后,模型是否还能用对证据,要由任务测试回答。 模型结构、材料组织和任务类型都会影响结果;100K、200K 等窗口规格本身给不出这个答案。
对前面的登录任务,可以把旧版 token 约束放进本轮任务说明,附上原文位置,再删去重复的会议背景。长文档则按需要切分、检索或摘要。调整之后,要继续检查模型是否仍然建议直接切换,而不能只确认输入 Token 变少了。
怎么评估上下文工程有没有变好?
先给任务写清楚成功条件,再比较修改前后的结果。 对售后咨询来说,要找到适用政策、说明尚缺的条件,并遵守用户授权。回答篇幅增加了,但仍用了旧政策,就不能算作改进。
任务结果之外,还要记录实现这个结果的代价:
| 指标类型 | 具体看什么 |
|---|---|
| 任务成功率 | 是否完成目标、是否需要人工补救、是否能稳定复现成功路径 |
| 工具质量 | 错选工具、漏调工具、参数错误、重复调用、危险操作拦截率 |
| 上下文成本 | 输入 Token、输出 Token、缓存命中率、压缩后信息保留比例 |
| 延迟指标 | 首 Token 延迟、端到端耗时、工具等待时间、p95 / p99 响应时间 |
| 结果质量 | 幻觉率、证据引用准确率、摘要丢失率、关键字段遗漏率 |
初期可以从 20 到 50 条真实任务轨迹开始排查,把正常任务和已知失败案例都放进去;样本少时只能用于发现问题,不能据此断言所有场景都有提升。比较时先固定模型、工具和判定标准,一次调整检索、压缩或 Prompt 中的一项;否则即使成功率上升,也难以确定是哪项改动起了作用。
运行时上下文怎么加载?
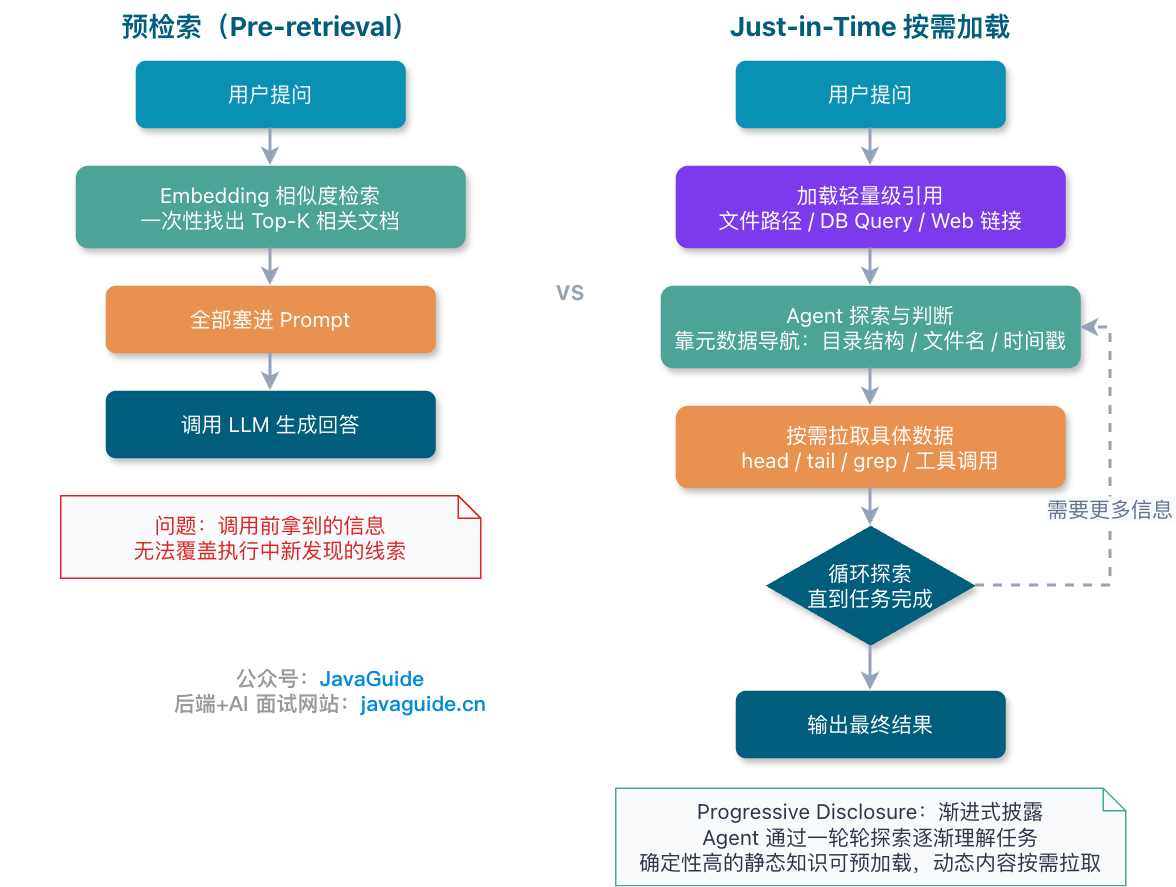
预检索为什么不够
预检索是在调用 LLM 之前查好资料,再把结果放入 Prompt。例如售后 FAQ 可以根据用户的问题做 Embedding 检索,取回有关退货期限的片段。
如果随后查询订单,才发现商品属于特殊品类,先前的检索就可能不够用了:检索时还不知道这个条件,自然也未必取回相应条款。Agent 需要根据新拿到的订单信息继续查资料。
Just-in-Time 按需加载
Just-in-Time 的做法是先保留引用,用到内容时再读取。 引用可以是文件路径、数据库查询或 Web 链接。
以 Claude Code 读代码为例,目录结构和搜索结果可以帮助它定位文件,再用 head、tail、grep 查看相关内容。文件名相同也不代表用途相同:tests/test_utils.py 位于测试目录,src/core_logic/test_utils.py 则位于业务代码目录。路径提供了查找线索,具体职责还要打开文件确认。文件大小和时间戳也可以帮助安排读取顺序,但不能单凭它们判断内容是否相关。
这种逐层读取材料的方式称为 Progressive Disclosure(渐进式披露)。窗口里先放导航信息,查到相关文件后再补充正文,因而无需在任务开始时读完整个仓库。Skills 也采用了这一思路,详见 Agent Skills 是什么?和 Prompt、MCP 到底差在哪?。
按需读取也有代价。每次搜索、打开文件都要调用工具;如果 glob、grep、tree 等工具没有提供有效线索,Agent 可能连续几轮都在错误目录里查找。因此,工具应提供可继续定位的结果,应用也需要限制搜索次数和耗时。与一次预检索相比,这条链路通常需要更多往返。
更现实的是混合策略
两种方式可以一起用。Claude Code 的一个例子是预先加载 CLAUDE.md 中的项目说明,具体代码文件再由 Agent 查找。项目约定不需要每轮重新搜索,尚未确定的实现细节则在用到时读取。
选择时可以先看材料范围是否已经确定。固定文档的问答、审阅,可以先检索或加载相关内容;代码库分析、故障排查往往要根据新线索扩大搜索范围,更需要运行时读取。任务名称本身不能决定方案,例如文书审阅一旦需要核对外部资料,同样需要补充检索。
| 策略 | 优点 | 代价 | 更适合的任务 |
|---|---|---|---|
| 预检索 | 快、简单、链路稳定 | 容易一次性塞入噪声,运行中不够灵活 | FAQ、固定知识库问答、稳定文档审阅 |
| Just-in-Time | 上下文更干净,证据按需进入 | 工具调用更多,延迟更高 | 代码库分析、故障排查、开放式研究 |
| 混合策略 | 兼顾启动速度和运行时探索能力 | 需要预算管理器和工具导航能力 | 复杂业务 Agent、长任务、多源检索任务 |
这几种策略都要保留证据来源。选择前还应确认资料更新频率、允许的响应时间,以及工具能否找到所需材料。
长任务里,上下文怎么撑住?

Compaction:窗口快满时压缩历史
Compaction 会用摘要替换较长的历史,让任务在新的上下文中继续。 对连续多轮的代码任务来说,需要留下的是已经作出的架构决策、未解决的 Bug、关键实现细节,以及继续工作所需的约束。重复的工具输出则可以移除。
Anthropic 介绍的 Claude Code 示例会把这份摘要与最近访问的文件一起带入新窗口。文章提到保留最近 5 个文件,这是该示例的做法,并不要求其他 Agent 也固定保留 5 个。具体保留哪些文件,要看下一步准备修改或检查哪里,以及窗口还剩多少容量。
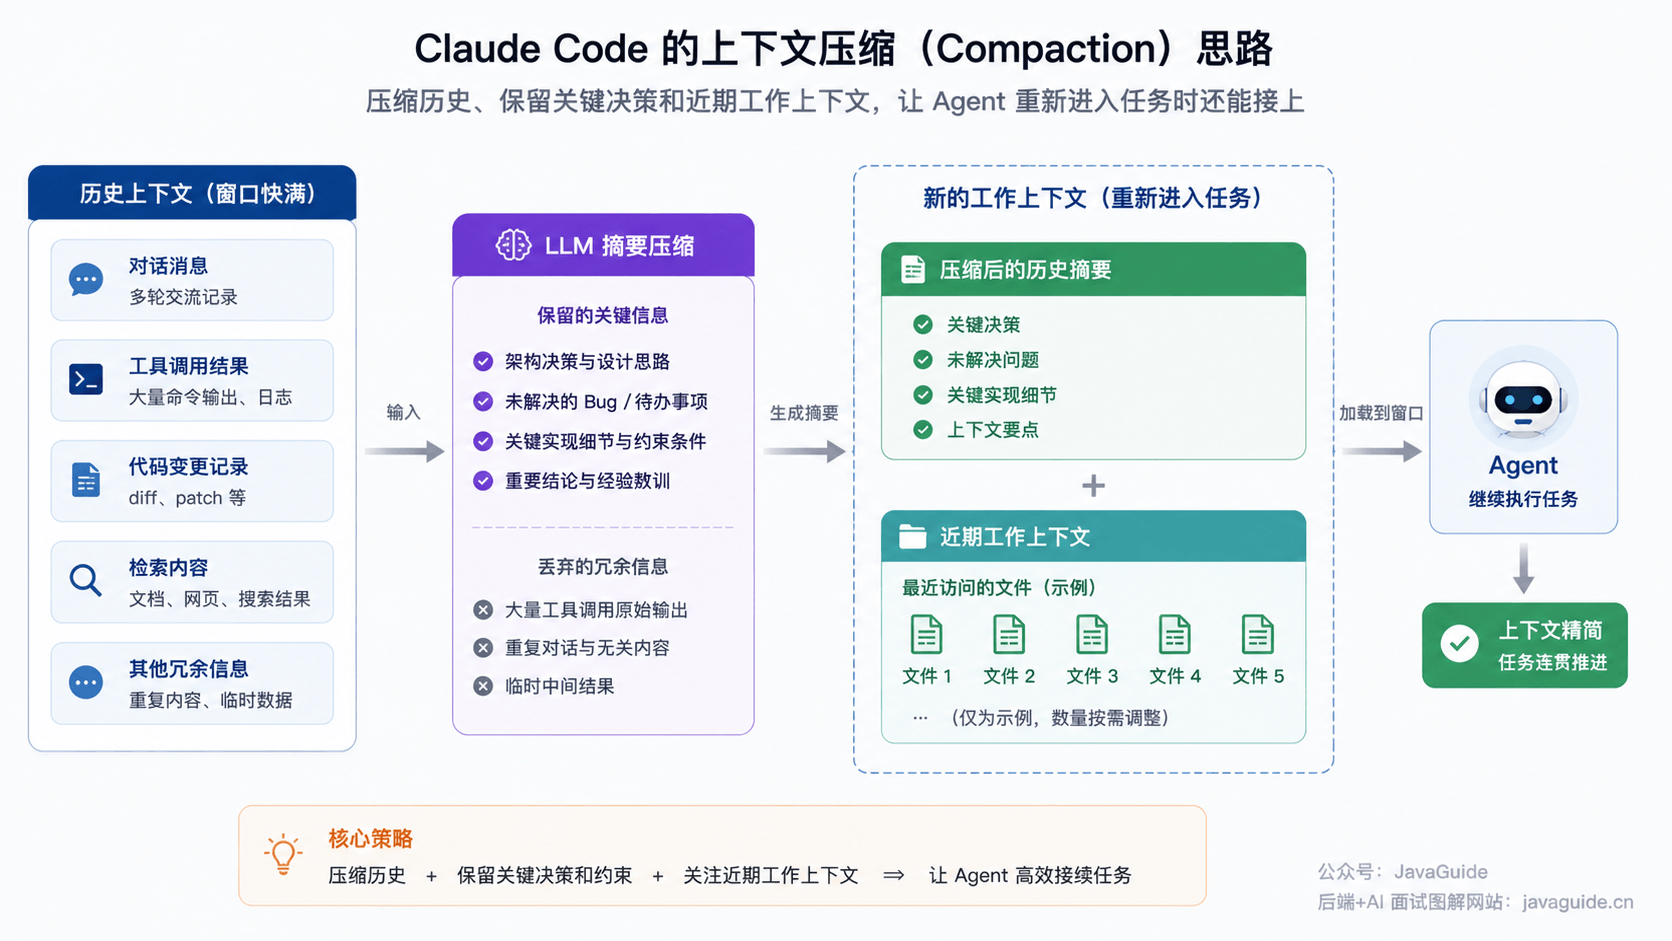
摘要写得短,不等于任务状态保留得准确。 例如,历史记录是“找到异常位置,尚未修复”,压缩后却变成“已完成排查”,下一轮就可能跳过修复。检查压缩效果时,可以从已有任务轨迹中取出这类尚未结束的步骤,对照摘要,看它们是否仍被标为待处理。确认没有漏项后,再删去重复输出。
大量重复日志不一定需要再生成一份摘要。Claude 的 Context Editing 可以在达到配置阈值后清理旧 tool_result:默认只清理结果,工具调用参数仍然保留;将 clear_tool_inputs 设为 true,才会同时清理参数。
例如,后续排障还要核对某次调用的日志,就应先保存原始结果及其读取位置,再让它从模型上下文中移除。触发阈值、保留多少次工具结果,都需要在具体任务上测试。
Structured Note-taking:让 Agent 记笔记
NOTES.md 可以用来保存任务进度:哪些步骤已经完成,还有什么问题,下一步检查哪里。它位于上下文窗口之外。换一个窗口继续任务时,Agent 重新读取文件,就能取得之前保存的进度,这种做法称为 Structured Note-taking(结构化笔记)。
笔记需要随着执行结果更新。例如某个 Bug 已经修复,但测试还没运行,就应该把这两件事分别记清楚。否则,下一轮读到的仍是旧的“待修复”条目。Anthropic 文中提到的 Claude Code 待办清单、自定义 Agent 的 NOTES.md,都是这类外部记录。
Anthropic 还介绍了 Claude 玩 Pokémon(宝可梦)的例子。Agent 将地图、成就和战斗策略写成笔记,并记录训练进度:过去 1234 步在 1 号道路训练,皮卡丘已经提升 8 级,目标是提升 10 级。上下文重置后,它读取这些记录继续游戏。它不需要重新读完此前所有消息,也能知道还差多少训练进度。Sonnet 4.5 发布时推出的 Memory Tool 公开测试版,也用于通过文件方式保存和查询窗口之外的信息。
Sub-agent:别让一个 Agent 扛所有状态
Sub-agent 可以把一部分阅读和搜索过程留在独立的上下文中。 例如,接口和相关测试的范围都已确定时,可以让一个子 Agent 读接口实现,另一个读测试。主 Agent 拿到的是实现结论、测试覆盖情况和文件位置,两个子任务的完整搜索记录不必全部进入主窗口。
如果还没定位到接口,就得先找到实现,再确定要检查哪些测试。这时两个步骤存在依赖,直接并行分配可能让查测试的子 Agent 搜错范围。回传结果也应写清“检查了哪些测试、还有什么没确认”,主 Agent 才能继续判断是否需要补查。
Anthropic 在上下文工程文章中描述过数万个 Token 的探索过程压缩为约 1000 到 2000 Token 摘要的模式;其 How we built our multi-agent research system 介绍了主 Agent 汇总独立探索结果的实现。这些数值来自文中的示例,不能作为所有子任务的输出上限。
需要保留连续对话、恢复任务进度,还是分开探索材料,可以分别参考下表:
| 技术 | 适用场景 |
|---|---|
| Compaction | 需要持续对话的长流程,重点是保持上下文连贯 |
| Note-taking | 迭代式开发、有清晰里程碑、多步推进的任务 |
| Sub-agents | 复杂研究、需要并行探索、最终要汇总结果的任务 |
上下文压缩后,怎么检查有没有丢信息?
检查摘要时,要同时核对任务进度和操作限制。 Anthropic 的 上下文工程实践强调保留决策和未解决问题。可以把这些要求放进一次订单排障中检查。
假设 Agent 正在排查“订单已付款,但页面仍显示待支付”。多轮对话和工具输出中包含:
- 用户只授权只读排查,不能修改订单、补发消息或执行退款。
- 订单号为示例值
O-1042,对应traceId=trace-demo-42,环境为测试环境。 - 示例任务当天 14:03 的支付查询返回成功;14:04 的订单查询仍显示待支付。
- 回调日志包含验签失败。错误时间与本次订单一致,但验签失败是否导致状态未更新,还需要继续核对。
- 已检查请求是否到达回调入口,尚未核对实例加载的证书版本与消息消费结果。
- 原始材料已保存为受控任务附件:P1 为支付查询结果,O1 为订单查询结果,L1 为回调日志。
压缩后的交接记录保留什么?
把上述记录压缩成一份交接摘要,可以得到下表:
| 内容 | 压缩后保留的信息 |
|---|---|
| 目标与范围 | 排查测试订单 O-1042 状态不一致,只读,不补发消息、不改数据 |
| 已确认事实 | 当天 14:03 支付查询成功;14:04 订单仍待支付;回调入口已收到请求 |
| 证据位置 | trace-demo-42;附件 P1(支付)、O1(订单)、L1(回调日志) |
| 待验证判断 | 验签失败可能影响状态更新,尚未确定因果关系 |
| 下一步 | 核对回调实例证书版本、对应消息是否产生及其消费状态 |
| 已做过的检查 | 已确认请求到达入口,避免重新做相同查询 |
这里的 L1 只是引用。只有日志已经保存,而且下一轮仍有读取权限,这个引用才有用。错误时间、关联标识和核对所需的版本信息应留在摘要中,重复堆栈可以放在附件里。工具输出尚未保存时,不能先删掉输出,再指望下一轮根据一个附件名称找回它。
什么样的摘要会误导下一轮?
“订单回调失败,重新发送支付通知即可”就是一份有问题的摘要。原记录还没有确认验签失败是否导致订单状态未更新,这句话却已经给出了修复动作,而且漏掉了只读授权。照此补发通知会越权,也可能重复处理支付消息。
可以先检查摘要中的引用。用 trace-demo-42 找到 P1、O1、L1,核对它们是否仍可读取、是否属于测试订单 O-1042,再按记录的时间和版本区分查询结果与推测。支付成功、订单待支付是已查到的事实;二者为何不一致,还要继续核对证书和消息状态。
下一轮的任务应当从这里接着做。摘要需要保留“只读,不补发消息、不改数据”,也要记下入口检查已经完成、哪些判断已经排除,否则模型可能越过授权或重复排查。
还可以固定模型、工具配置和返回条件,用原历史与压缩摘要分别续接同一任务,比较后续调用。模型若请求补发通知,即使执行端成功拦截,这一次也没有满足只读要求。如何记录和判定这些结果,见 AI 应用评测体系。
Context Engineering 到底怎么落地?
应用代码负责把用户任务、会话状态和业务上下文转换成模型请求。这段逻辑可以封装为 Context Assembler(上下文组装器),输出 messages、工具定义和附加信息。
以前面的订单排障为例,历史摘要提供待办和已做过的检查,业务服务提供支付查询结果,日志用于核对回调情况。组装器把这些材料与只读授权放入本轮请求,同时选出可用工具。支付状态以业务查询为准,组装过程不重新推断它是否成功。
先看一轮 LLM 调用前,系统到底要组装什么
# 输入:用户任务信息、当前会话状态、业务上下文
input: user_task, session_state, business_context

# 1. 加载系统约束(限制条件、策略规则、权限等)
constraints = load_system_constraints()

# 2. 根据用户任务和会话状态,提取当前要达成的具体目标
goal = extract_current_goal(user_task, session_state)

# 3. 使用 RAG(Retrieval-Augmented Generation)策略检索相关证据或上下文信息
#    - 例如从文档、知识库、数据库中找到与 goal 相关的数据
#    - 参考「运行时上下文怎么加载」文档说明检索策略
evidence = retrieve_rag(goal, business_context)

# 4. 回忆历史记忆或会话中已有信息
#    - 包含用户偏好、先前交互、模型记忆
memory = recall_memory(goal, session_state)

# 5. 根据目标、证据和记忆选择合适的工具/操作组件
#    - 可以是调用 API、执行浏览器操作、触发计算等
tools = select_tools(goal, evidence, memory)

# 6. 压缩会话历史消息,用于跨窗口上下文管理
#    - 参考「长任务里,上下文怎么撑住」
#    - 压缩历史可减少 token 消耗,同时保留关键信息
history = compact_history(session_state.messages)

# 7. 聚合所有上下文信息,并进行重要性排序
#    - 按任务需要安排材料位置,实际效果仍需评测
context = rank([
  constraints,
  goal,
  evidence,
  memory,
  tools,
  history
])

# 8. 根据模型的 token 限额对上下文进行截断/裁剪
#    - 优先保留目标、约束和必要证据,裁剪后检查是否遗漏
context = fit_token_budget(context)

# 输出:生成的消息、可用工具 schema、附加元信息
output: messages, tool_schema, metadata
rank 和 fit_token_budget 分别负责材料排序与预算裁剪,需要应用实现相应策略。订单排障中,反复出现的堆栈可以压缩,完整日志可以留在附件中,通过引用读取;只读授权仍应留在请求里。按消息时间直接删掉最早的内容,就可能把这条授权限制一并删掉。
context 是上述伪代码使用的中间结构。发送请求时,工具定义要放入 API 对应字段,消息也要区分指令与外部材料,检索文档不能因为“很重要”就被提升为系统指令。rank 改变的是输入位置,并不控制模型的执行顺序。模型最终是否遵守约束,需要通过结果检查;权限则由执行端校验。
静态规则:先把 System Prompt 写清楚
System Prompt 可以约定排障 Agent 的角色、操作限制和输出格式。这些要求相对稳定,用 Markdown 标题分开即可。订单状态、日志内容则随任务提供或更新,不适合写死在这份指令里。
例如,排障报告需要包含证据和待验证项,就可以在指令中明确:
## 角色

你是一个后端服务故障排查专家,擅长通过日志和监控数据定位问题根因。

## 约束

- 只调用必要的工具,不重复调用相同逻辑的工具
- 证据足以支持结论时停止搜索;证据不足时列出待验证项,不把推测写成确定根因
- 优先使用实时数据而非历史推断

## 执行流

1. 查监控指标(CPU/内存/网络)
2. 查对应时间范围的日志
3. 如发现异常调用链,追踪上下游依赖
4. 输出结构化报告:问题描述 → 根因 → 建议修复方案

## 输出格式

使用 JSON,包含字段:incident_summary, root_cause, evidence, recommendation
在编码工具中,这类规则也可以保存到 .cursor/rules、.claude/rules 或 AGENTS.md,纳入版本控制和团队审查。宿主程序负责按目录和作用域加载;文件中的内容何时进入模型、转换成哪类消息,要看对应工具的实现。
上面的示例给出了报告字段和调查步骤,比“做一个有帮助的助手”多了可执行的要求。但也不必把每种故障写成一组 if-else:告警条件一变,整套分支就可能需要重写。指令应说明怎样取证、何时可以下结论,给模型留下根据新线索继续调查的空间。Anthropic 把这个具体程度称为 Goldilocks zone。
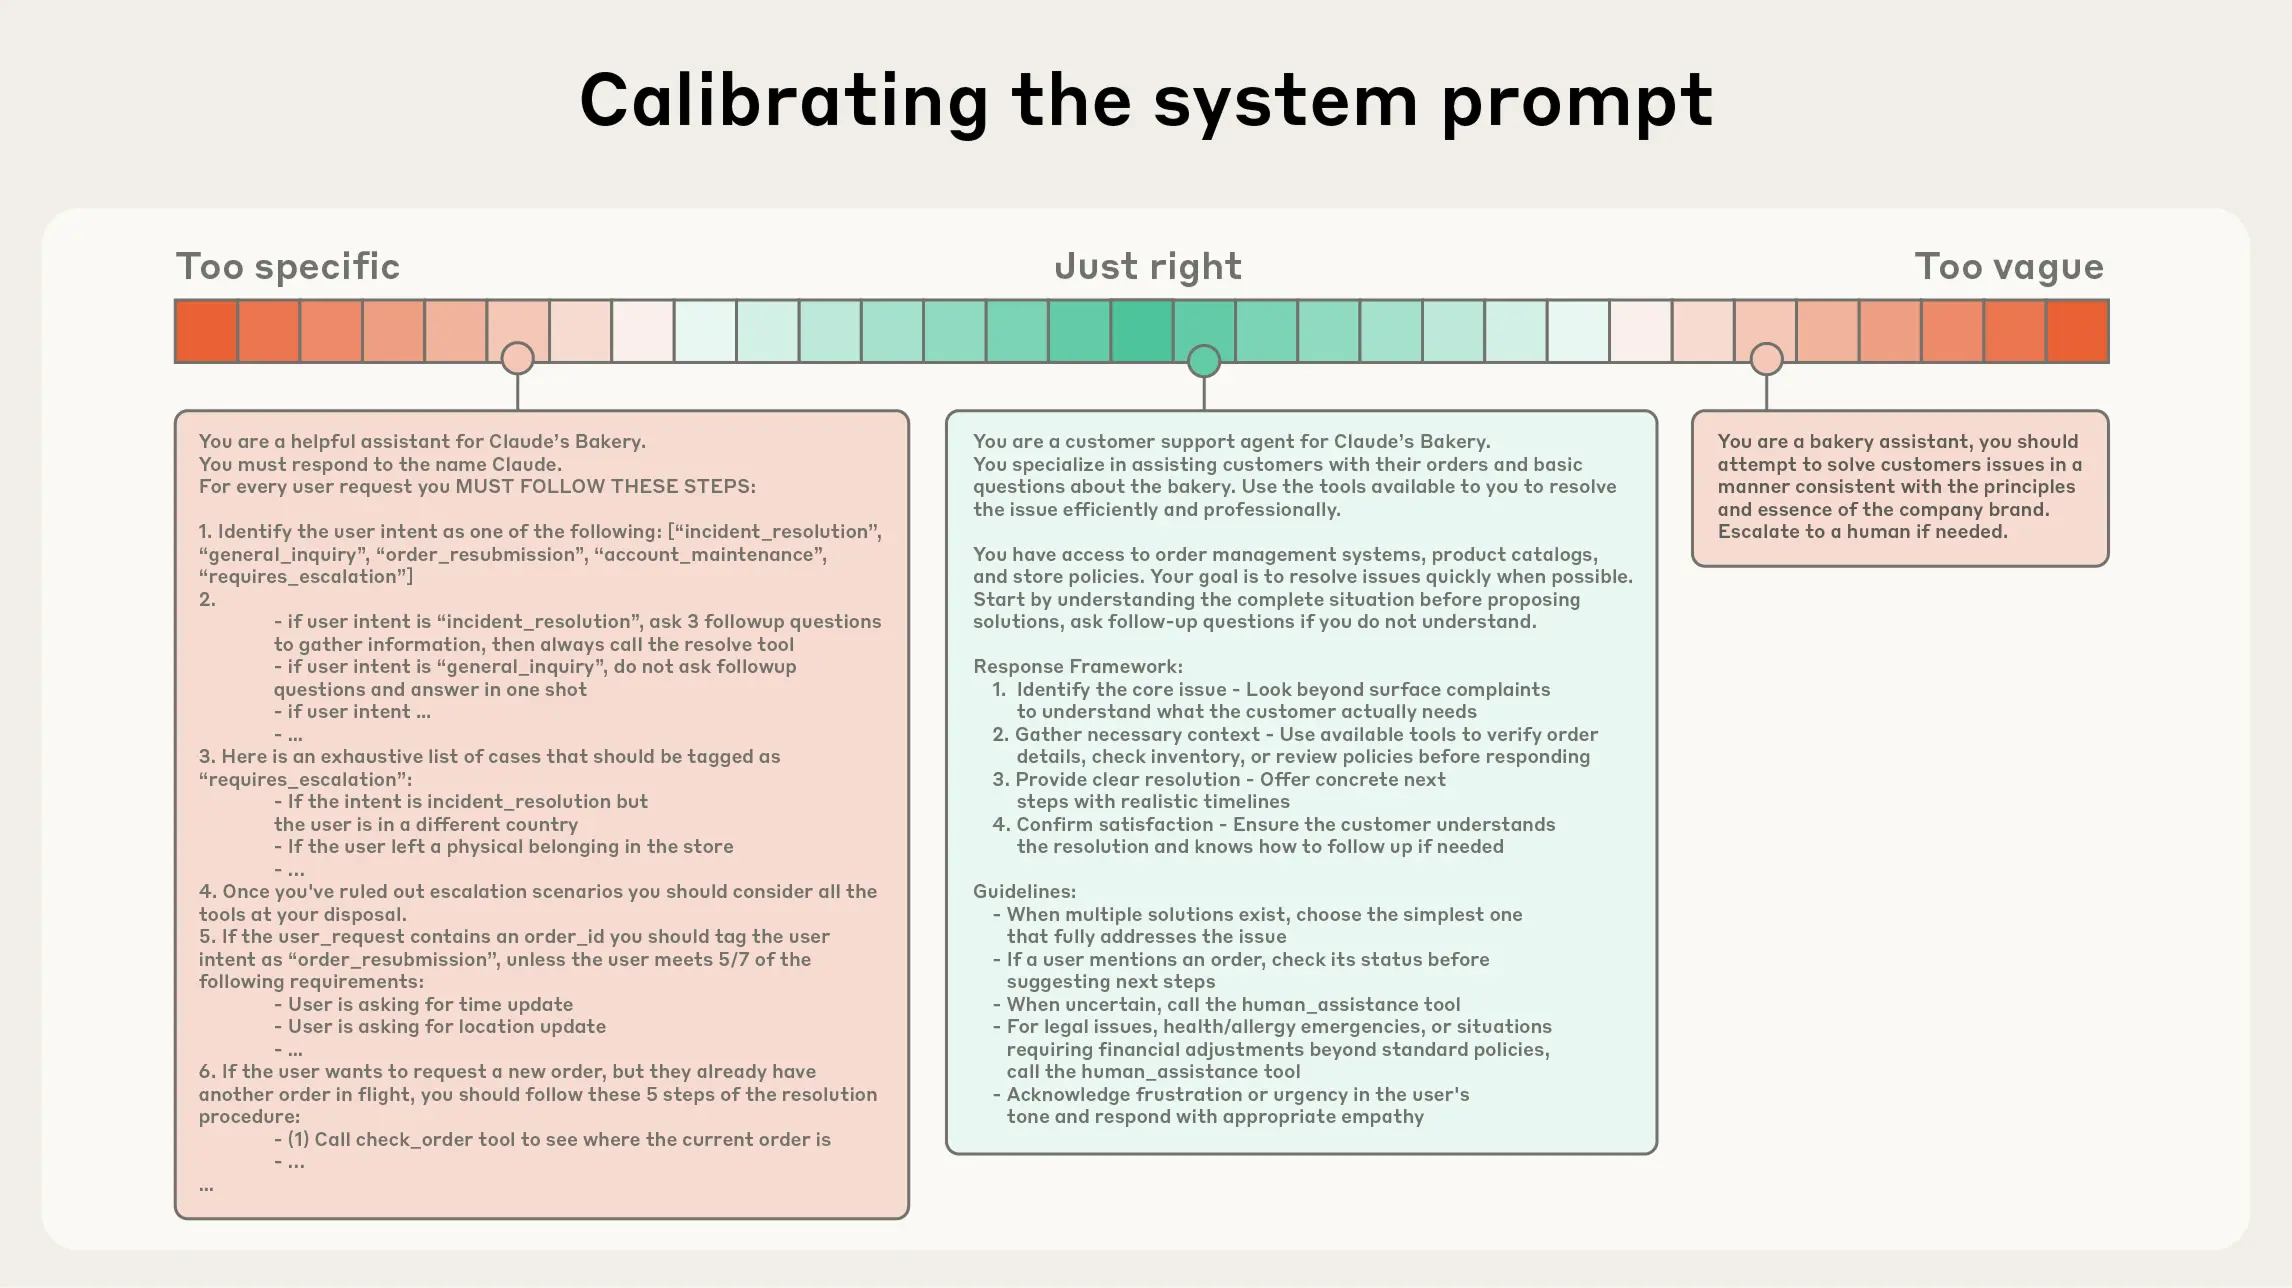
Anthropic 所说的 Calibrating the system prompt,可以从一份能说明任务要求的最小 Prompt 开始测试。例如报告把尚未核实的验签问题写成根因,就检查指令是否要求区分事实与推测,补充或澄清后再测。若根本没有取回回调日志,应修复检索或工具调用,而不是给 Prompt 再加一句“认真分析日志”。
工具上下文:工具描述要先讲边界
“处理订单”这个描述没有说明工具究竟是查数据还是改数据。对模型来说,两个都与订单有关的工具就可能难以区分。查询、修改和审批可以拆开描述,分别写明用途、参数格式、适用条件和禁止条件。
例如,创建退货单会改变业务状态,描述中就应说明需要哪些订单信息,以及调用前须取得用户确认。模型据此选择工具,后端则检查这次调用是否获得授权。工具描述不能代替权限校验。 即使 Prompt 写了“禁止修改”,执行端收到未授权的修改请求时,仍要拒绝执行。
动态上下文:RAG、记忆、工具结果不要一股脑塞
前面的订单查询记录了 14:04 的“待支付”状态。排查这个时间点的问题时,它是证据;用户询问订单现在是否支付成功时,则可能需要重新查询。同一份工具结果是否还能用,取决于本轮要回答的问题,不能只看它是否还在滑动窗口里。外部记忆中的旧状态也一样。
排障日志可以裁掉重复堆栈,但要留下 traceId、请求时间、错误码、调用参数以及原文位置。下一轮需要详情时,再按引用读取;原始材料及读取权限不能随上下文裁剪一起丢掉。
检索无结果、工具超时、摘要漏字段,处理的位置并不相同。检索服务可以尝试其他检索方式,工具调用层负责限制等待和重试,摘要缺项则需要回查原始记录:
| 失败路径 | 典型表现 | 兜底方案 |
|---|---|---|
| RAG 无结果 | 找不到相关文档,或者召回片段太散 | 降级到关键词检索,必要时让 Agent 向用户澄清缺口 |
| 工具超时 | 外部 API 卡住,Agent 重复等待 | 设置超时、重试上限、熔断策略,关键流程预留人工接管 |
| 摘要丢失 | 压缩后缺少异常栈、版本号、边界值 | 保留 traceId、原始证据位置、关键字段和可回查链接 |
| 记忆污染 | 旧偏好、旧状态被当成当前事实 | 写入前校验,读取后标记来源、时间和可信度 |
| 多工具冲突 | 两个工具都能做,Agent 选错路径 | 用优先级、状态机和副作用等级约束调用顺序 |
表中的重试还要考虑操作是否有副作用。创建退货单超时,只能说明调用方没有及时收到结果,不能据此认定退货单没有创建。重试应依赖接口的幂等保证;结果不明确时,可按业务提供的标识查询状态,避免重复创建。关于超时与重试的区别,可以参考 AWS Builders’ Library。
示例上下文:Few-shot 示例别堆太多
给售后助手准备示例时,可以分别演示信息齐全与信息缺失的情况。订单条件齐全,就依据适用政策说明资格;缺少签收时间,先查询或询问;找不到适用政策,则说明缺口并转人工。
这就是 Few-shot 示例需要覆盖的差异。只替换商品名称,却始终给出相同处理结果,模型学不到条件变化时该怎么做。初次测试可以准备 3 到 5 个例子,再根据遗漏的场景补充。这个数量是测试起点,Anthropic 对 canonical examples 的建议是多样且有代表性,并没有规定固定个数。是否增加示例,还要看评测结果。
Token 预算:单次调用内怎么排优先级
压缩历史后,当前轮次的检索结果和工具定义仍可能超过预算。因此,还要在组装这一次请求时决定保留哪些内容。历史压缩由前文的 Compaction 处理,单次请求的裁剪可以参考下表。
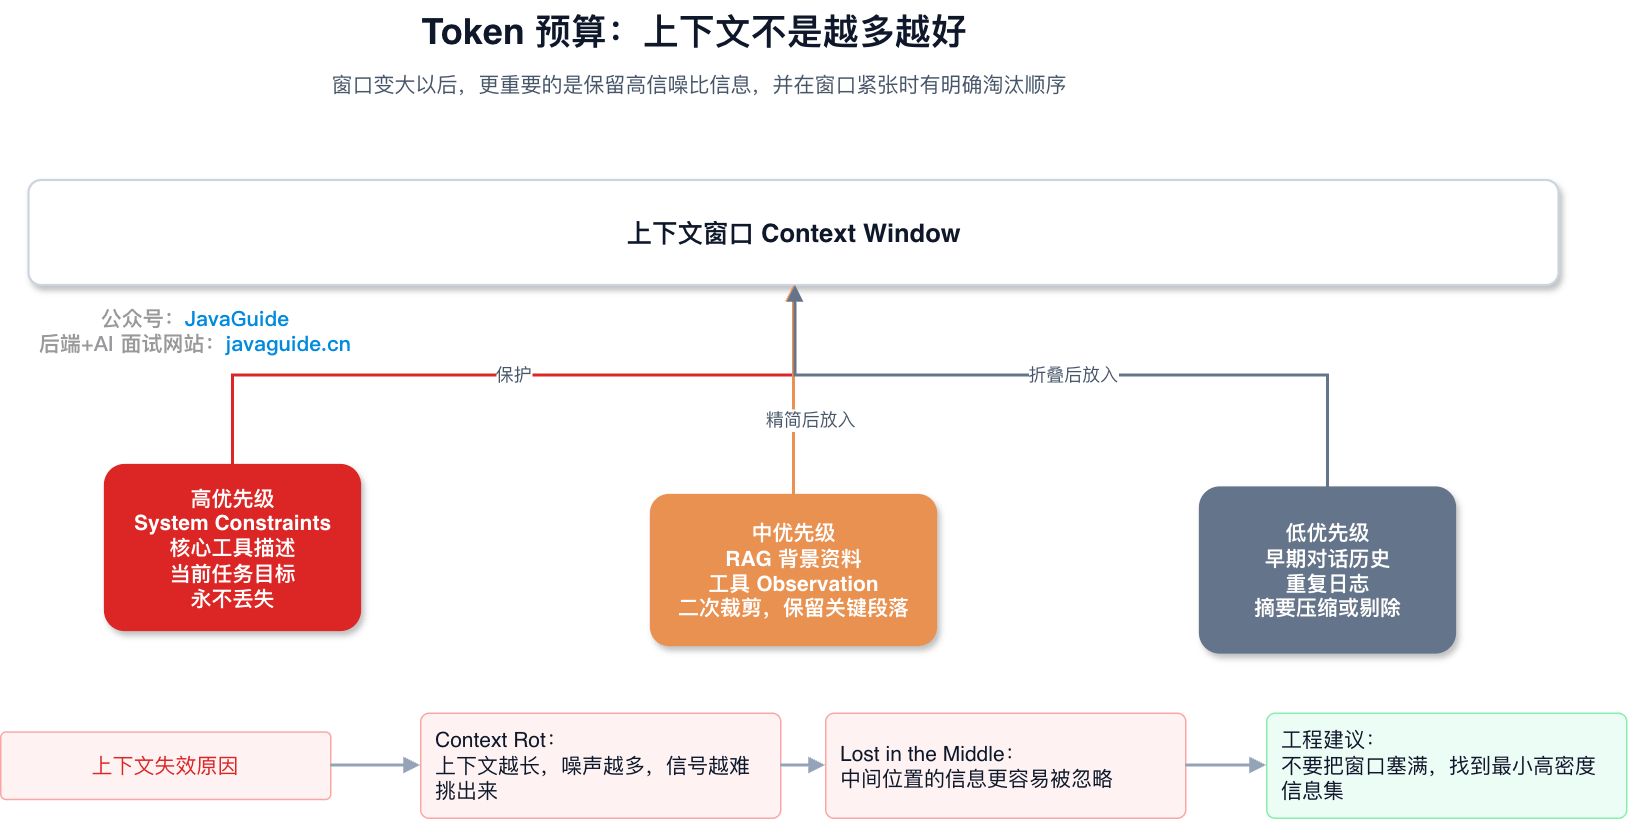
| 优先级 | 内容 | 处理方式 |
|---|---|---|
| 低优先级(可折叠) | 早期对话历史 | AI 摘要压缩 |
| 中优先级(可精简) | RAG 检索的背景资料、旧工具结果 | 二次裁剪,保留核心段落和可回查引用 |
| 高优先级(固定区) | System Constraints、当前任务目标、安全边界 | 放在固定高优先级区,确保逻辑一致性 |
| 阶段性优先级 | 当前阶段需要的工具描述、Schema、少量关键示例 | 按任务阶段加载,卸载后保证可重新发现 |
对于支持 Prompt / Context Caching 的模型,可以复用稳定的 System Prompt 和工具说明。前缀频繁变化或缓存过期时,收益会减少,具体还取决于厂商的缓存规则。记录实际命中率和首 Token 延迟,才能判断缓存是否起作用;即使命中缓存,上表中的内容裁剪仍然需要执行。
做 Context Engineering 会用到哪些工具?
编排、检索、向量库、工具接入和记忆层解决的问题不同,只引入当前任务链路需要的部分。
- LangChain、LangGraph 负责控制流、状态管理和循环调度;工具调用与节点回退通常在这一层组织。
- LlamaIndex 偏向 RAG 的数据摄取、索引生成和检索优化,适用于文档摄取与检索构成主要链路的场景。
- Pinecone、Weaviate、Chroma、Qdrant 等提供 Embedding 存储和语义搜索。小项目可先用本地 Chroma,再按规模评估 Qdrant、Milvus 或 Pinecone。
- MCP 规定工具如何标准化接入宿主程序,区分 Host、Client、Server,并暴露 Resources、Prompts、Tools 等能力。协议版本与调用示例统一见 MCP 专文。
- Mem0、LETTA(原 MemGPT)、ZEP 面向 Agent 记忆层,通常在向量库之上封装记忆写入、检索和遗忘等生命周期管理。
例如,通过 MCP 调用数据库查询,查询服务仍需限制用户能读到的数据;调用配置修改工具,服务端仍需校验授权并记录变更。接入协议解决了工具如何被发现和调用,应用与工具服务的这些检查依然要执行。
落地时先记录每轮上下文
一次调用完成后,可以把检索输出与实际发送的消息对应起来看。仍以前面的登录改造为例:检索结果有旧版 token 校验约束,最终消息里却没有,就沿过滤、摘要和预算裁剪过程找它在哪一步消失了。
如果最终消息中也有这条约束,模型仍建议直接切换,问题就发生在材料进入请求之后。此时再调整检索条件未必有效,需要检查材料组织、模型输出及其依据。
这类排查需要同一次调用的检索结果、消息、工具 Schema 和 Token 使用量。日志只记一句“检索成功”,无法区分上述两种情况。
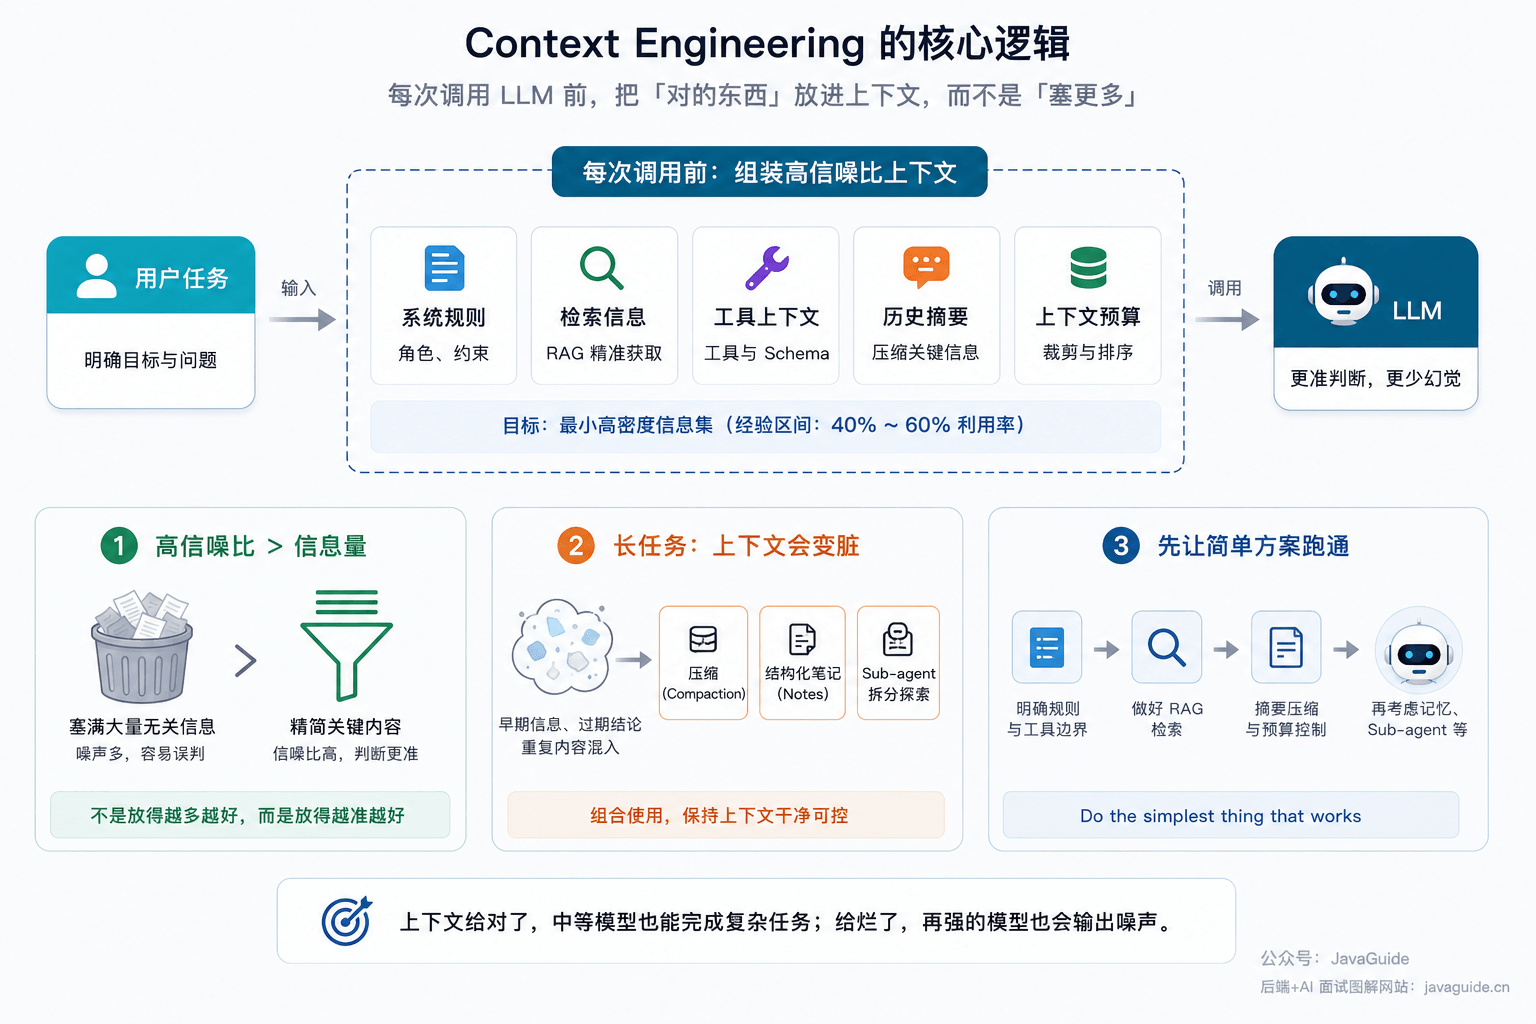
高信噪比比信息量更重要
登录改造中的兼容性约束只有一句,却决定能否直接切换模块。重复的会议背景可能有几页,对当前选择并没有提供更多依据。裁剪时可以合并后者,保留前者;长度并不能代表材料的重要程度。
Dex Horthy 在 上下文工程实践文章中使用过 40% 到 60% 的上下文利用率经验区间。它可以作为测试参考,但并不是通用的质量标准。是否保留了兼容性约束、模型是否据此作答,仍要用当前任务检查。
长任务要主动清理过期状态
代码改完以后,笔记中的“待修复”就过期了,但也不能直接改成“已验证”。此时应记录改动位置,把测试列为待办。测试返回后再写入结果:通过了哪些检查,还有哪些失败或未执行的检查。下一轮读取这份记录,就能继续验证,而不必重新修改同一段代码。
笔记在窗口之外,切换窗口后可以重新读取;窗口内已经积累的长历史,则可由 Compaction 压缩。Sub-agent 回传独立探索的结果后,主 Agent 还要据此更新任务记录。按任务中实际出现的问题选择即可,几轮能完成的任务通常用不到全部三种方式。
先把最简单的方案跑通
Anthropic 在上下文工程文章中的建议是:do the simplest thing that works。
以售后问答为例,可以先实现服务端查询订单、检索政策、模型回答这条流程。返回了错误政策,就核对文档版本和检索条件;订单状态没有传入,就检查请求组装。先找到这一次失败发生在哪一步。
单轮流程可用后,再测试连续追问、订单状态变化和长对话。只有这些任务出现历史过长或进度丢失等问题,才有依据判断需要增加哪种上下文管理方式。
从可回放的基线开始
重新执行订单查询,可能得到与原来不同的状态。因此,保存 Prompt 还不足以回放一次任务,工具返回值和当时检索到的材料也要保存。配置记录则应包含 model ID、接口版本、核对日期、使用的规则和工具定义。
例如要比较两种检索策略,就先固定模型和工具条件,再替换检索部分。长上下文、Prompt Caching、结构化输出及 MCP 的支持情况,仍按对应的模型、API、SDK 和客户端版本核对。同时更换模型与检索策略,只能比较整套配置,无法单独判断检索改动的作用。回放用于提供可对照的输入和环境,也不意味着模型每次都会生成完全相同的结果。
总结
上下文工程的检查对象是每次调用实际发给模型的内容。资料没找到,就检查检索;找到了却没进入消息,就检查组装与裁剪;换窗口后无法继续任务,就检查摘要和外部记录。保留调用轨迹后,这些问题才有具体的排查依据。
修改之后,用相同任务检查证据引用、授权遵守和实际结果。Token 变少、摘要更短可以说明开销变化,但还需要确认任务是否完成。
参考
- Effective context engineering for AI agents - Anthropic
- OpenAI API Models Compare
- Claude API Models Overview
- DeepSeek V4 Preview Release
- MCP:协议版本、能力与调用示例
- Context Rot: How Increasing Input Tokens Impacts LLM Performance
- Lost in the Middle: How Language Models Use Long Contexts
- Context Engineering: The New Frontier of AI Development
- The New Skill in AI is Not Prompting, It Is Context Engineering
- Context Engineering by Simon Willison
- 12 Factor Agents - Own Your Context Window