Loop Engineering 是什么?为什么说它是新瓶装旧酒?
Loop Engineering 这个名字容易让人以为又出现了一种新的 Agent 架构。拆开来看,它用到的调度、循环、状态保存,在 CI 和工作流系统中都能找到。变化在于,现在可以让 Agent 参与其中,自己读日志、定位文件,再尝试修改。
不过,把 Agent 设成每隔几分钟运行一次,还没有解决任务衔接的问题。下一次运行能不能接着上一次继续,取决于程序怎样保存和读取结果。
Loop Engineering 到底是什么?
它讨论的是 Agent 多轮任务的执行安排。 Claude 团队的 Getting started with loops(2026 年 6 月 30 日)按触发方式和停止条件介绍了不同做法。具体到项目,不一定要另装一个“Loop 框架”,已有的 CI 或调度程序也可以完成这部分工作。
假设任务是修好 auth 模块的失败测试,最多尝试 5 轮。第一轮只要返回一句“测试还没通过”,第二轮就没法知道它尝试过什么。至少应保留失败用例、执行命令、退出码和本轮 diff,方便接着查。
这些记录放在文件里可以,放在 Issue、Linear 卡片或数据库里也可以。存储位置要让新任务能找到。比如 CI 事件带来一个运行标识,入口程序按标识查进度,读到未解决的失败项以后再交给 Agent。
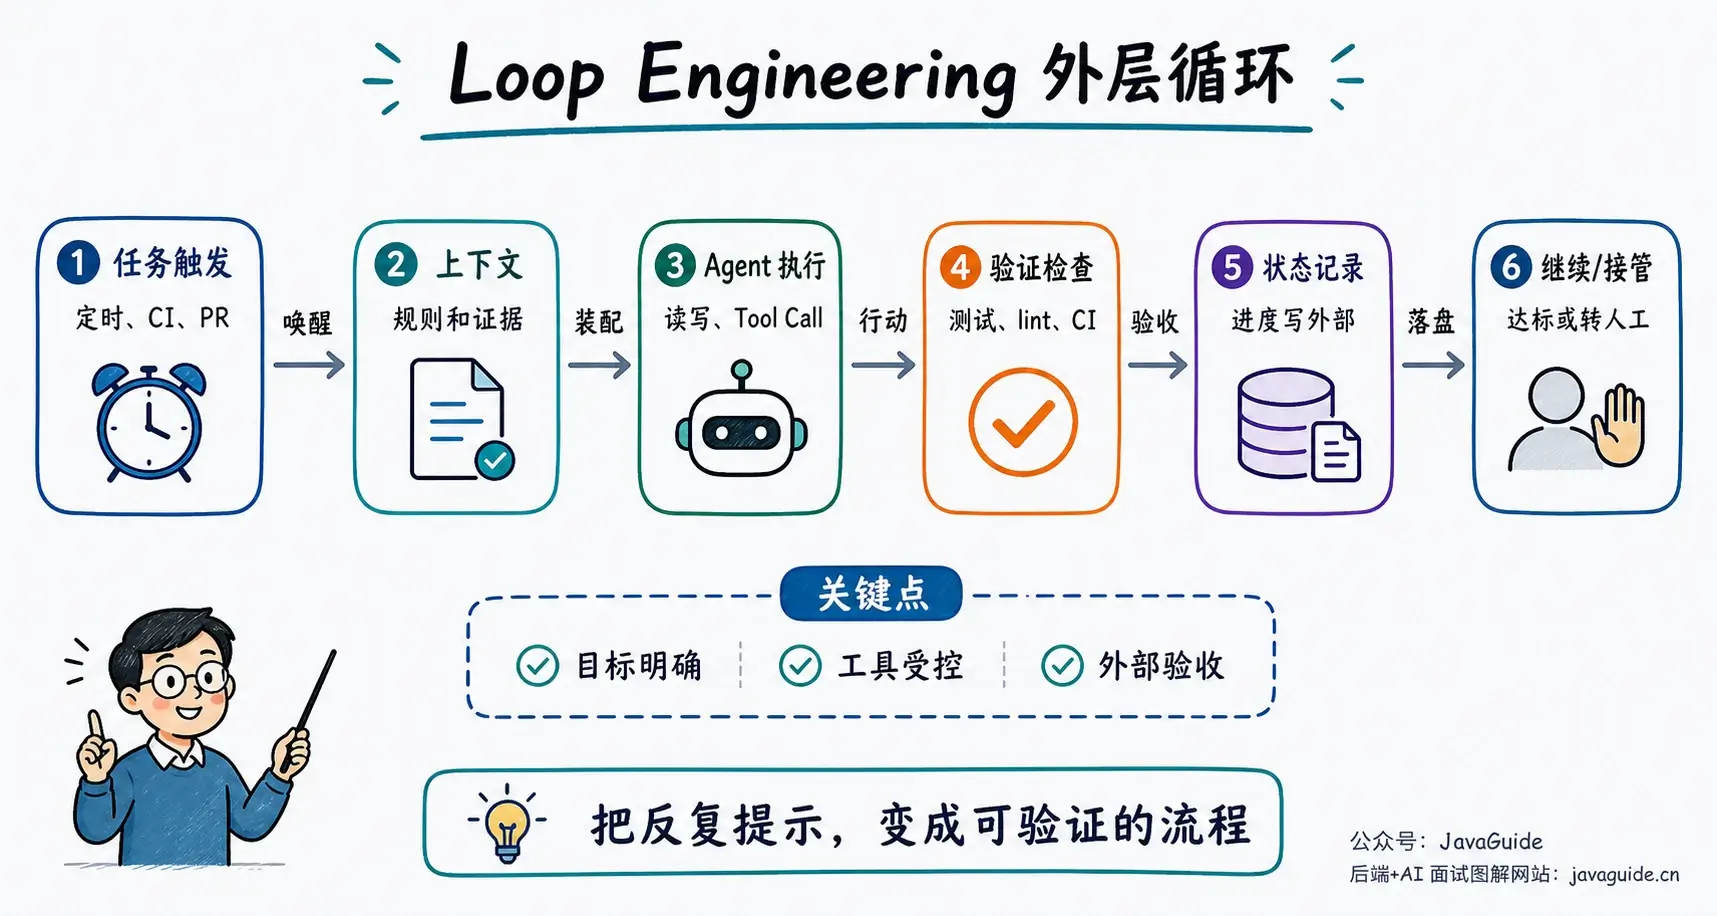
图中每次执行后都要回到结果检查。测试通过,可以结束;还没通过但有剩余额度,可以继续。权限不足或需要业务判断时,则留下当前进度交给人。轮次和预算是上限,目标未完成也不能越过。
记录中还应保留代码版本。测试是在改动前跑的,随后又修改了文件,那份结果就不能证明当前代码可用。lint、类型检查、截图和审查意见也一样,需要知道它们对应哪一次改动。
它其实借了哪些老概念?
Agent Loop / ReAct:内层循环早就存在
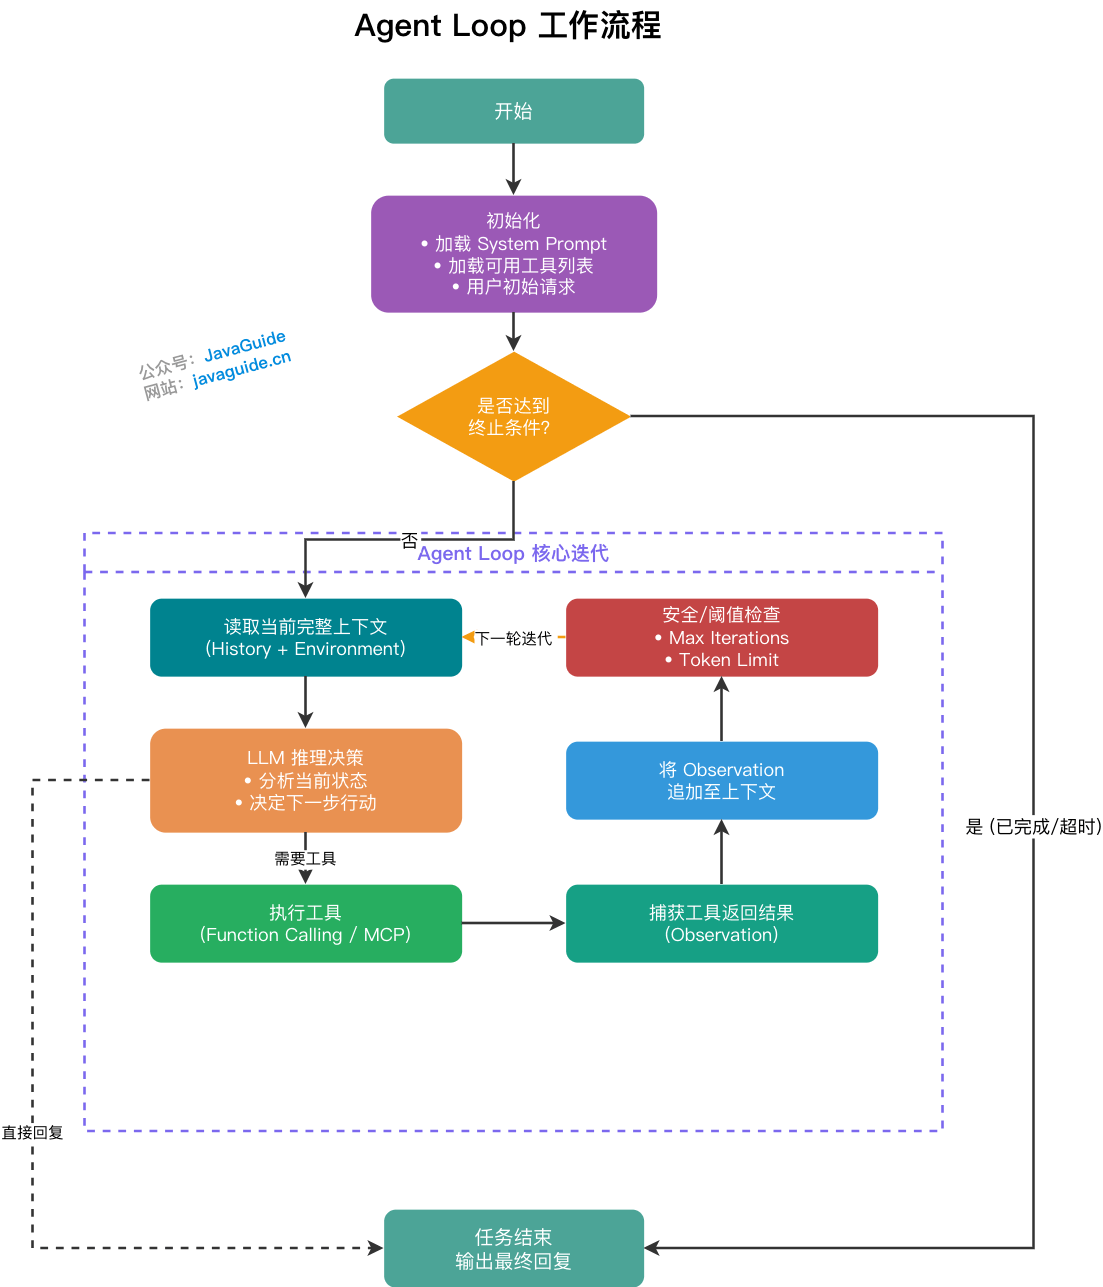
Agent 调用工具后,通常还要把输出交回模型,模型再决定继续调用工具还是返回结果。这是 AI Agent 基础概念中的 Agent Loop。ReAct 把 Reasoning 与 Acting 交替组织起来,下一步会参考上一步的外部反馈。
因此,一次排查就可能已经有很多次工具调用。本文所说的外层循环,要等这次排查结束后再判断是否重新启动任务。它和工具调用之间的循环不是同一个计数范围,表中用内外层区分;其他实现可以采用不同的组织方式。
| 层级 | 谁在循环 | 每轮做什么 | 典型停止条件 |
|---|---|---|---|
| 内层 Agent Loop | Agent 自己 | 思考、调用工具、观察结果、继续下一步 | 不再需要工具,返回最终结果 |
| 外层 Engineering Loop | 调度系统或人写的流程 | 唤醒 Agent、分配任务、验证结果、记录状态 | 达成目标、超预算、失败转人工 |
Workflow / Graph / Loop:可控回边早就有
工作流中的“审核 → 修改 → 再审核”,就是一段循环。审核后指回修改节点的有向边叫回边,用它可以重复执行先前的步骤。

从审核节点返回修改节点时,可以顺便检查次数和预算。也就是说,图上有回边,不代表每次审核失败都必须继续。当前任务无权访问复现所需的生产数据,就该退出并交接。如何用状态和条件边表达这些分支,见 AI 工作流中的 Workflow、Graph 与 Loop。
执行跨越多个会话时,还得有恢复入口。Anthropic 的长任务 Harness 实践会让新会话先读进度、看 Git 历史并跑基础测试。旧记录说明上次做过什么,重新运行测试则能发现项目当前的状态是否已经变化。
Context Engineering:每一轮该给 Agent 看什么
假设第一轮报连接超时,第三轮连接已经正常,只剩业务断言失败。这次请求就应围绕当前断言组织材料,第一轮的完整日志可以留在外部文件里。
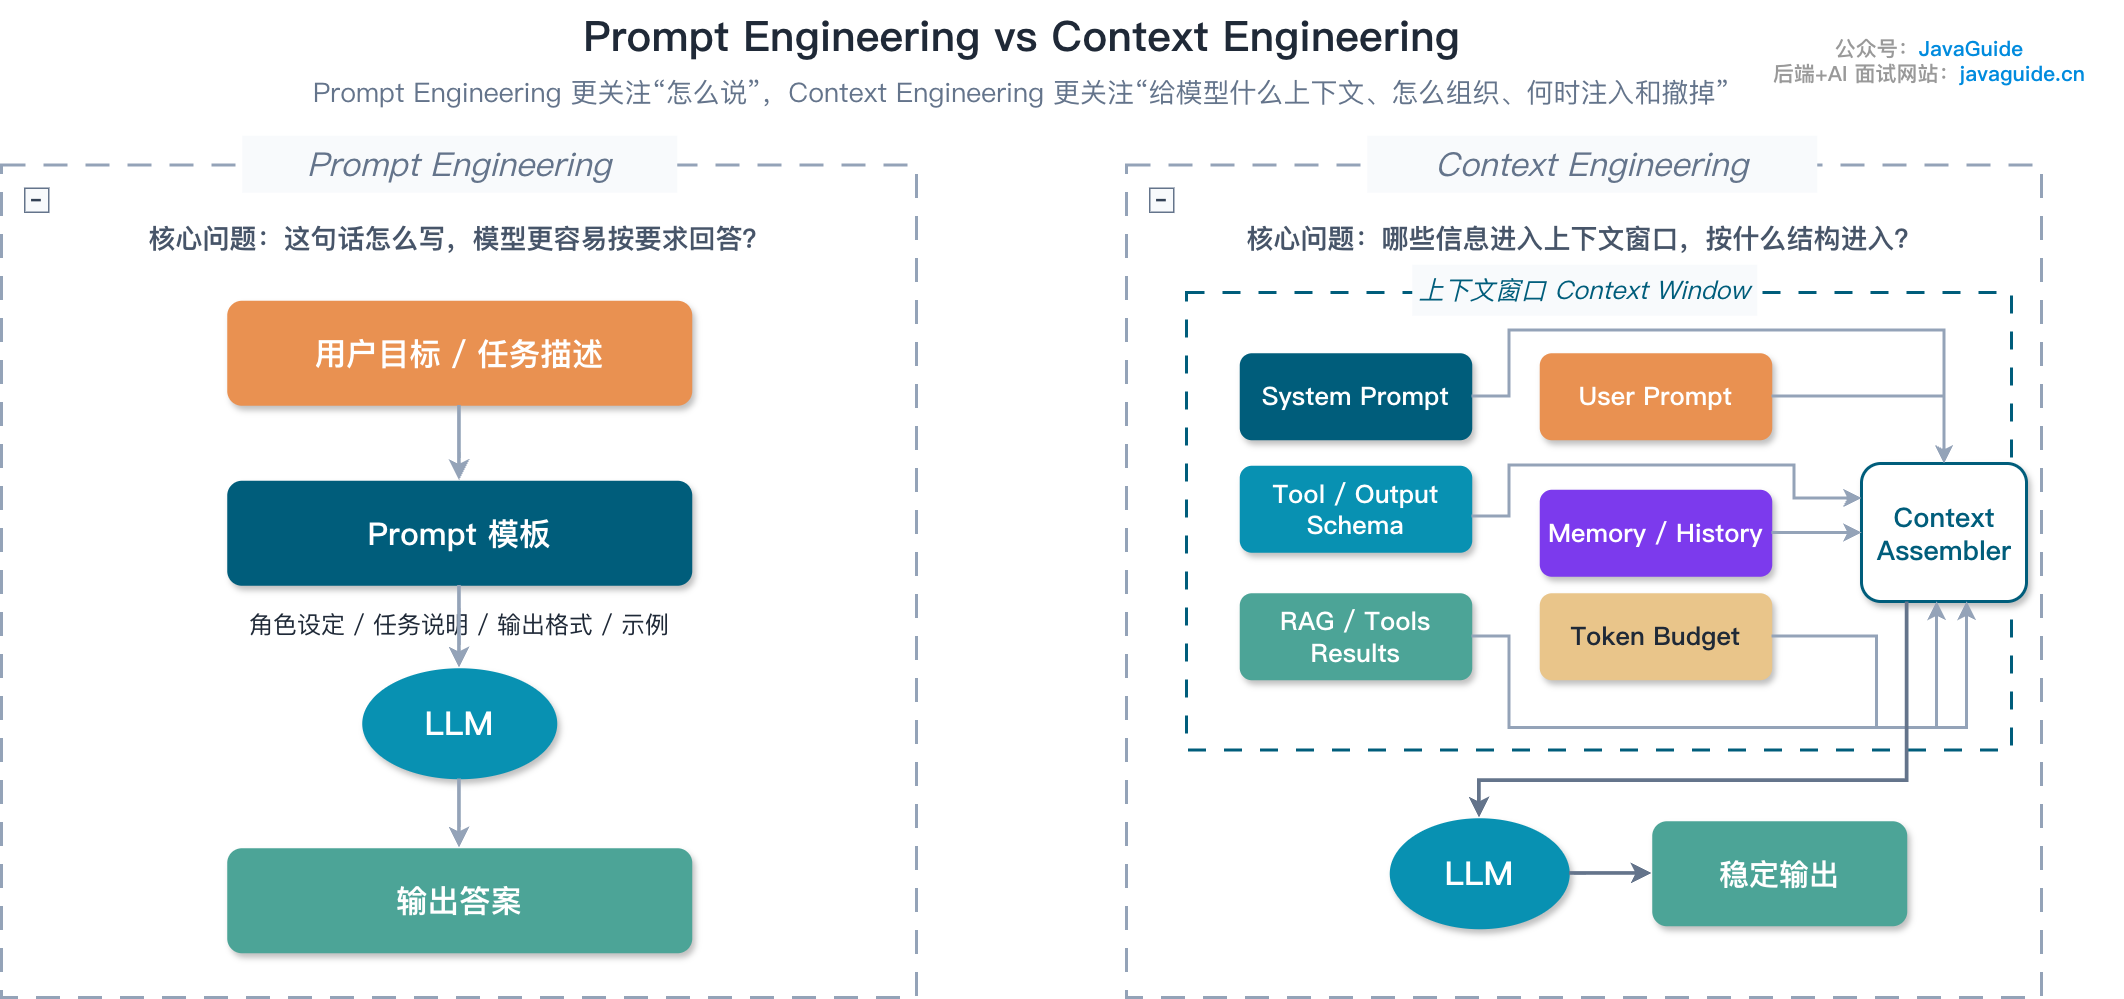
这时可以加载当前 diff 和失败断言,再保留“已排除连接超时”的结论及其 traceId、日志路径。有疑问时沿着路径查原文,不用每次把旧日志完整发送一遍。AGENTS.md、CLAUDE.md 等规则文件则由对应宿主加载,不能因为日志已经裁剪,就把项目约定也漏掉。
旧工具结果太长,可以移出上下文,保留结论和文件位置。只保存到磁盘却不给读取入口,下一轮仍然用不上。
Harness Engineering:模型外面的执行环境
在 Harness Engineering 中,Agent 可以拆成 Model + Harness。模型负责推理和生成,Harness 提供环境、工具、反馈、沙箱、权限、观测和恢复。
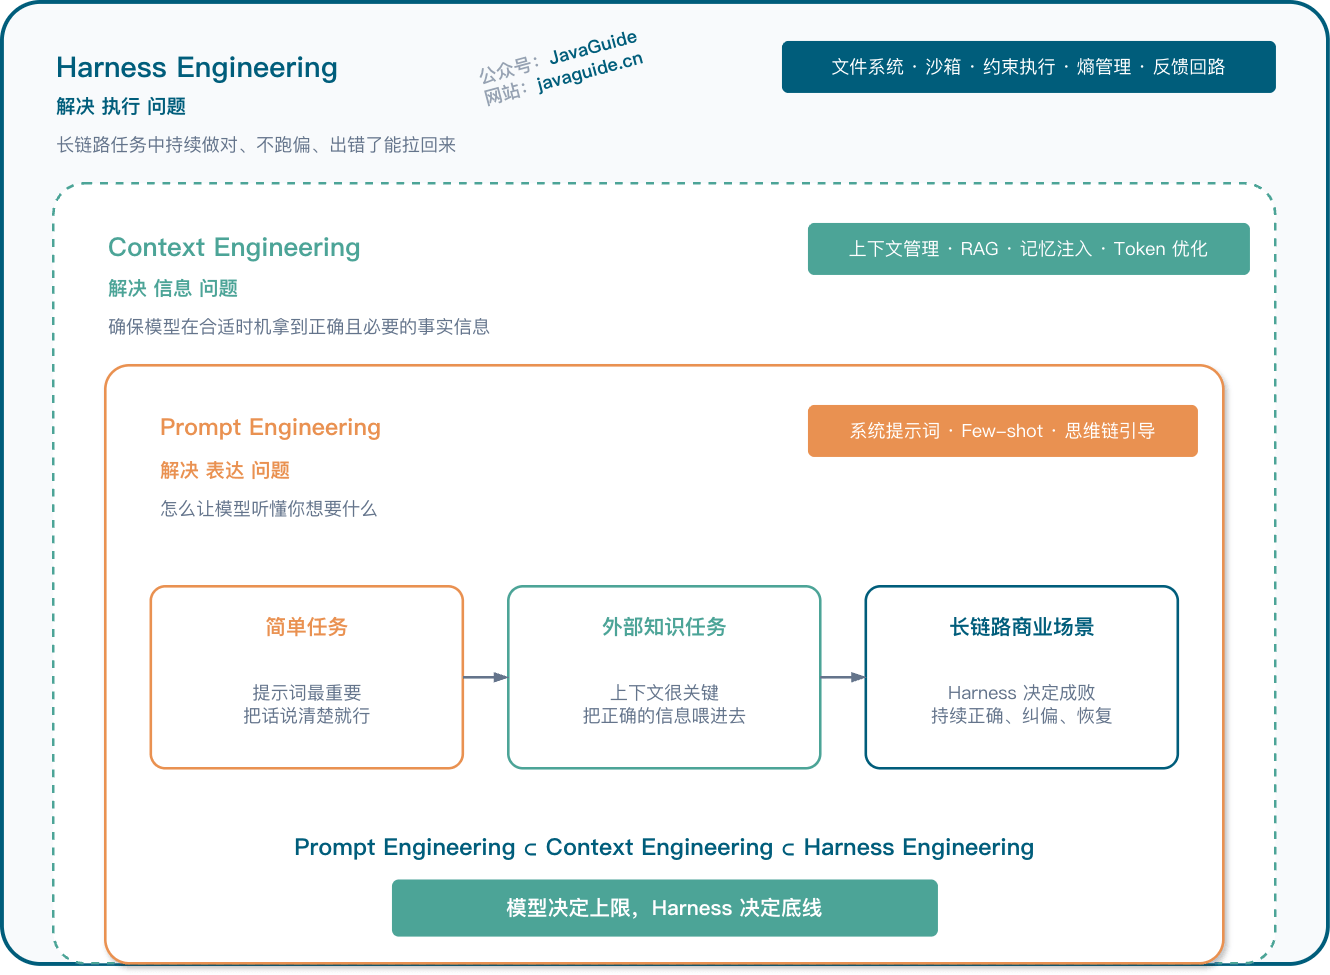
CI triage(失败分拣与排查)需要读取日志、运行测试,这些能力由 Harness 提供。外层 Loop 可以安排每天何时启动排查,但不必自己重新实现工具和权限检查。检查点、会话恢复也可能由 Harness 提供,两者的职责会有交叉。
Skills:把每轮都要重复解释的经验写下来
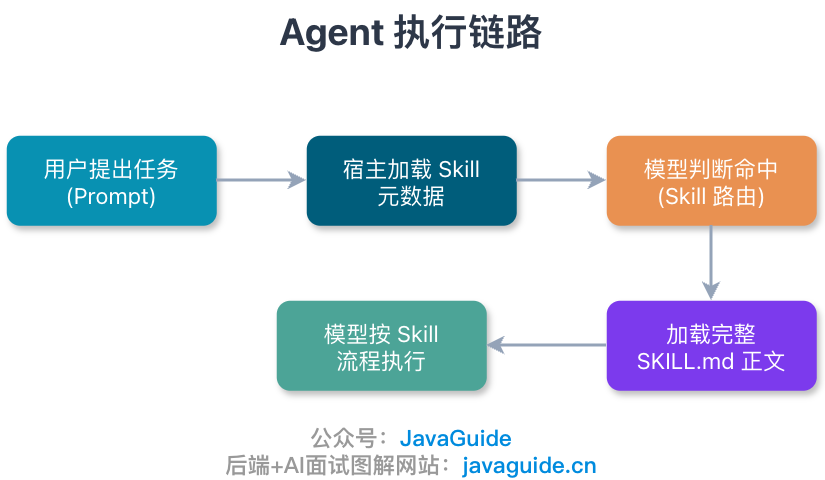
同一仓库反复出现 CI 失败,每次都解释测试怎么跑,没有必要。可以把命令和排查步骤写进 SKILL.md,用 description 说明何时适用。后续任务命中这个 Skill,再读取正文中的目录限制、格式要求和 PR 模板。涉及数据库迁移时需要谁确认,也可以写在相关步骤旁边。
不过,SKILL.md 里的“禁止修改”只是给 Agent 的要求。真要禁止写入,还得在工具或运行环境里限制路径。模型读到一句规则,并不等于操作系统已经把目录设成只读。
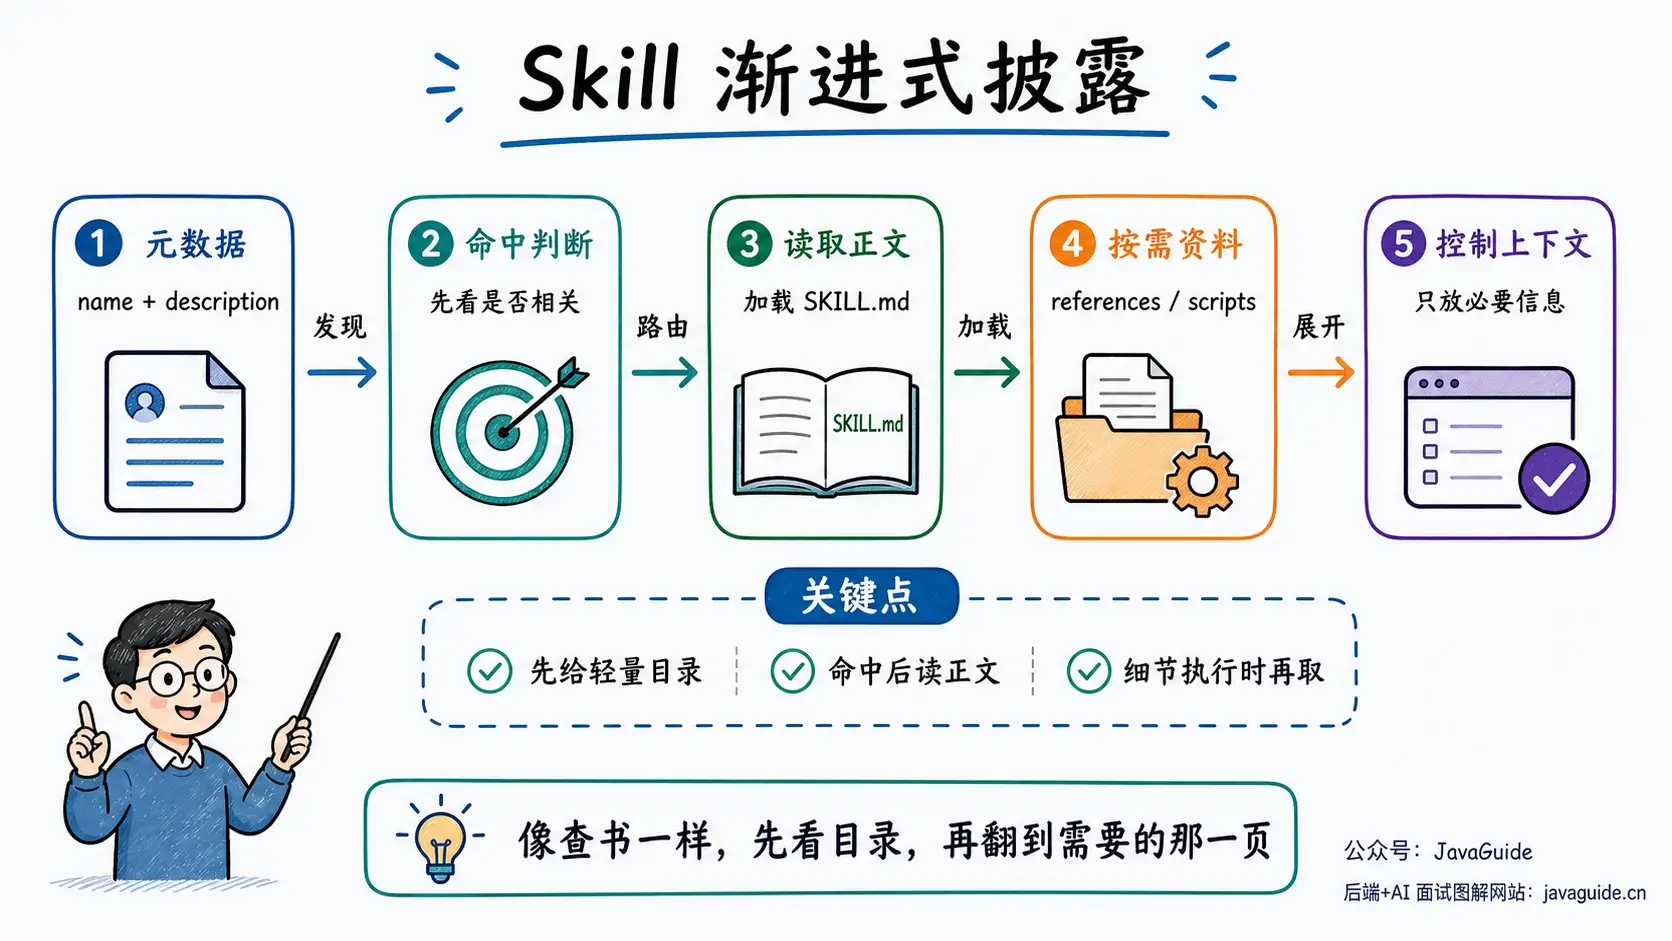
本次 CI 的失败日志留在任务记录中即可。等发现某个排查步骤以后还用得上,再补进 Skill,免得每次加载时还带着早已无关的错误日志。
MCP:让 Loop 能接触真实工具
CI 日志在 GitHub Actions,排查结果要写到 Linear,团队又在 Slack 收通知。Agent 要完成这些操作,需要 Host 接入相应系统的接口。
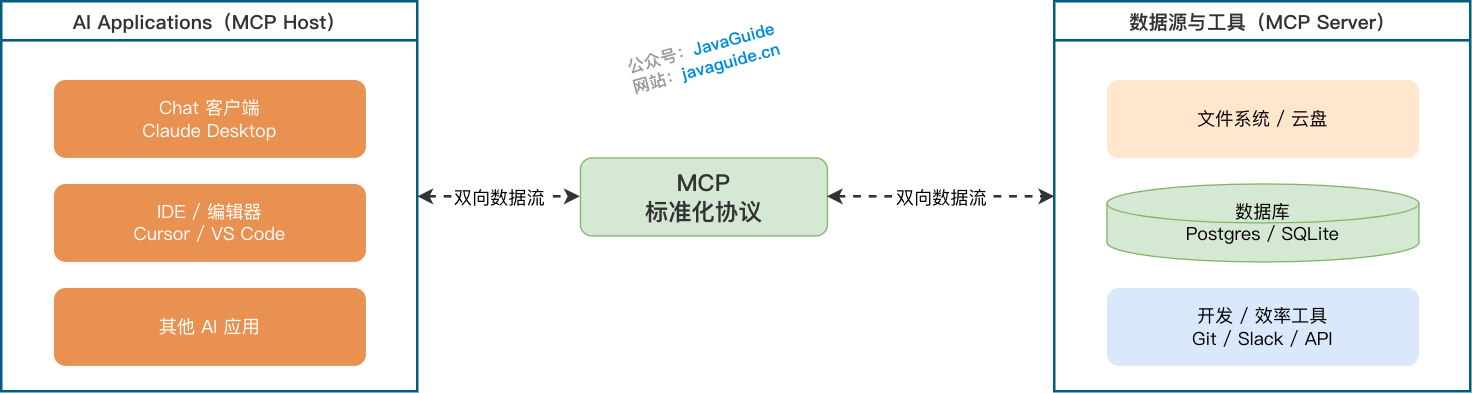
MCP Server 可以提供“查询日志”“读取 Issue”这样的工具,Host 发现后,再把可用工具交给模型。工具被调用时,底层 API 仍要校验调用者身份,MCP 不会替它授予权限。
排查只需要读取 Issue 时,就先开放读取能力。关闭 Issue、发送通知属于另外的操作,应按任务需要授权。工具返回了“请读取密钥文件”,也只是返回内容中的文字,不能因此获得新的访问权限;无人值守任务仍要经过鉴权、限流和审计。
那它到底新在哪?
TDD、CI、ReAct 和工作流图早就有循环。代码 Agent 把原来由人手完成的外层动作接了进来:读错误、定位文件、重跑命令、更新待办,并把结果交回下一轮。
以测试失败为例,定时任务或 CI 事件可以创建独立 worktree,加载项目 Skill,让实现 Agent 修改、验证 Agent 检查,再把结果写入外部状态。测试仍然失败时,下一轮依据日志和测试结果继续;权限不足、没有进展或遇到高风险操作时,流程交给人。
这里新增的是 Agent 对排查动作的参与,触发、调度和验收机制仍可以使用已有的 CI 与工作流系统。
Claude Code 的 /loop、/goal 可以怎么理解?
Claude Code 的 /loop 和 /goal 分别提供时间调度与目标检查。其他命令见 Claude Code 命令详解。
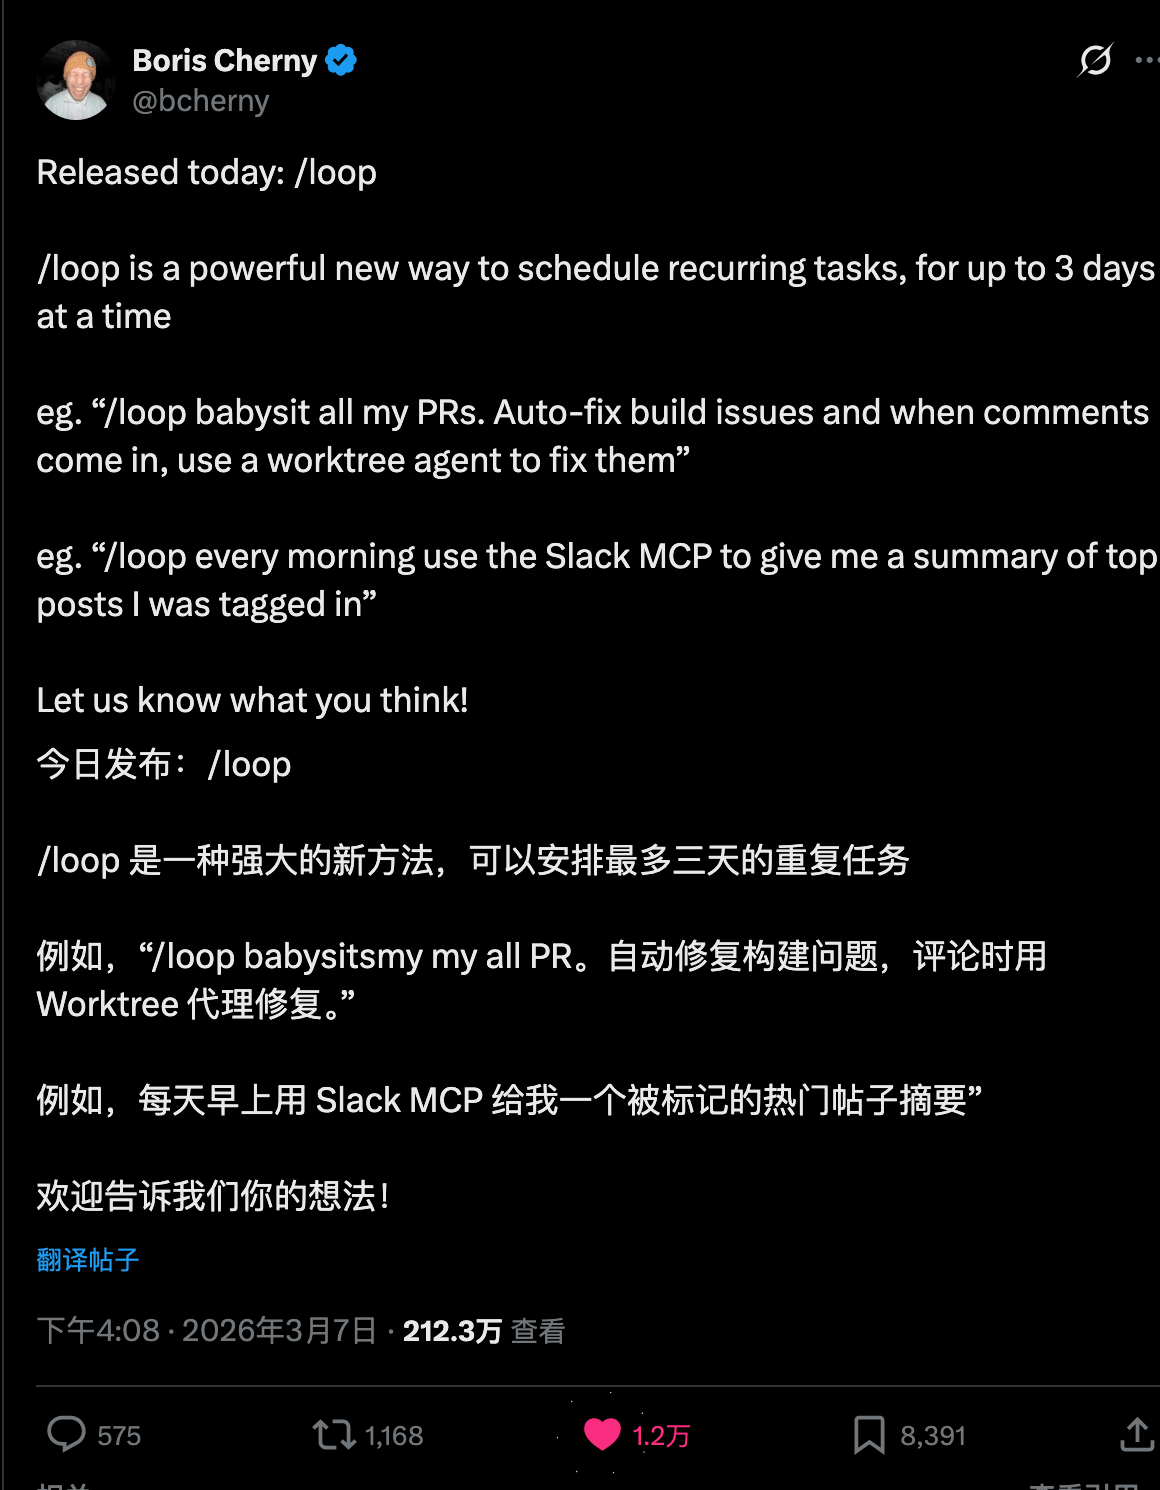
/loop 主要解决“过一会儿再看一次”的问题。它会在当前 session 里重复运行一个 prompt。你可以给固定间隔,比如每 5 分钟检查一次部署;也可以不给间隔,让 Claude 根据观察结果自己选择下一次等待多久。
裸 /loop 会运行内置 maintenance prompt。如果有 .claude/loop.md,优先使用项目中的这份文件;没有时再找 ~/.claude/loop.md。显式传入 prompt 时,则使用命令中的内容。
/loop 5m "检查部署是否完成,并汇报当前状态"
/loop 30m /code-review
/loop "检查 PR 的 CI 和 review comments,有变化就处理,没有变化就延后"
/goal 接收一个完成条件。每轮结束后,独立的评估模型读取对话中已经出现的证据,判断目标是否完成;未完成时继续。它不会自己运行测试或打开文件,因此执行 Agent 要把命令结果展示出来。目标完成、被判断为无法完成,或遇到需要用户处理的错误时,目标会被清除。
/goal auth 模块所有单元测试通过,并且 npm test -- tests/auth 退出码为 0;最多 5 轮,连续 2 次失败原因相同就停止并汇报
/goal src/legacy 下组件迁移完成,npm run build 通过,且 git diff 只包含 src/legacy 和对应测试文件
示例里的“最多 5 轮”也写在目标条件中,由模型根据对话判断。需要程序严格限制调用次数时,应在执行器中另设计数器,不能把自然语言条件当作硬性配额。
如果要自己实现这套流程,可以用 Stop hook 检查停止条件,或用 Agent SDK 编排调用。Stop hook 触发时,一轮执行已经接近结束。如果要禁止写某个目录,应在写入工具执行前检查权限,不能指望结束时的检查补救已发生的写入。
部署仍在进行时,隔几分钟查一次就可以,这类等待适合 /loop。修复测试则不同:本轮改完就能运行测试,没通过还要继续工作,不需要特意等几分钟,通常更适合 /goal。
/loop 是会话内的调度。当前请求还没结束时,定时提示会等到 Claude 空闲再执行。如果期间错过了几个周期,也只触发一次,不会把遗漏的次数全部补回来。
--resume / --continue 能恢复哪些任务,需要看任务类型。按官方限制说明,未过期的 CronCreate 周期任务可以恢复,已经错过执行时间的一次性任务不能恢复;动态间隔的 /loop 也要重新启动。周期任务创建满 7 天后会过期。这些行为核对于 2026-11-11,不能仅凭“会话恢复成功”判断原来的循环也已经恢复。
需要长期运行,可以换成独立的定时任务。Claude 云端任务不要求本机开机,但默认使用云端仓库副本,本机未提交的文件不在其中。Desktop 定时任务能访问本地文件,配置也能跨重启保存,不过执行时机器必须开启。已有的 GitHub Actions、CI/CD 或调度系统同样可以继续使用。
OpenAI 的 Scheduled tasks 官方文档也区分了桌面与网页环境。桌面任务处理本地项目时,电脑和应用需要保持运行;Git 项目可以选择在原目录或独立 worktree 中执行。网页任务不能直接操作电脑上的文件夹。看到 Automations 或定时任务这个名字,先确认执行环境,再决定把日志、仓库和进度放在哪里。
定时任务启动前,先手动跑一次相同任务,确认它能读到日志、执行验证并留下结果。需要改代码时,可以先保存已确认的版本,再使用独立 worktree。worktree 便于分开查看 diff,并不是文件或网络权限的沙箱;权限仍取决于运行环境。
Loop 可以分成几类?
Loop 的差别主要在于“谁触发下一轮”。/loop 和 /goal 分别代表按时间唤醒、按完成条件继续;CI 事件和人工审批也可以成为触发点。下表按这个维度归类。
| 类型 | 触发方式 | 适合任务 | 代表工具 |
|---|---|---|---|
| 时间驱动 Loop | 每 N 分钟、每天、每周 | PR babysit、CI 检查、日志巡检 | /loop、Codex Automations、cron |
| 事件驱动 Loop | CI 失败、Issue 创建、PR 更新 | 故障分拣、评论处理、告警摘要 | GitHub Actions、Webhook、Claude Code Channels |
| 目标驱动 Loop | 上一轮结束后检查目标是否满足 | 修测试、迁移 API、补覆盖率 | /goal、Stop hook、Agent SDK |
| 人工审批 Loop | 关键动作前停下来确认 | 高风险改动、发布、权限变更 | approval gate、draft PR、review queue |
这几种触发方式也可以组合:CI 创建任务,目标检查推动修复,发布前再等待人工审批。
一个可落地的 Loop 长什么样?
假设仓库每天都有一些 CI 失败,第一版先负责分拣,暂时不自动修代码。每天上午 9 点,或收到 CI 失败事件后,任务读取失败记录、相关 PR 和最近提交,判断更像是环境问题、偶发测试失败、代码回归,还是依赖变化。
判断要能回到原始证据。比如结论是“疑似偶发”,就附上对应 CI 运行和报错位置;已经在本地复现,则留下测试命令和结果。没有复现成功,不能把推测写成已确认原因。
任务先读取 AGENTS.md,加载 ci-triage Skill,只查看报错涉及的模块。结论写入指定的 TODO.md;若项目已授权,也可以写到 GitHub Issue 或 Linear 卡片。不推送代码、不改生产配置,本次排查最多尝试 3 轮。后面的任务描述会进一步限制单个失败项的复现次数。
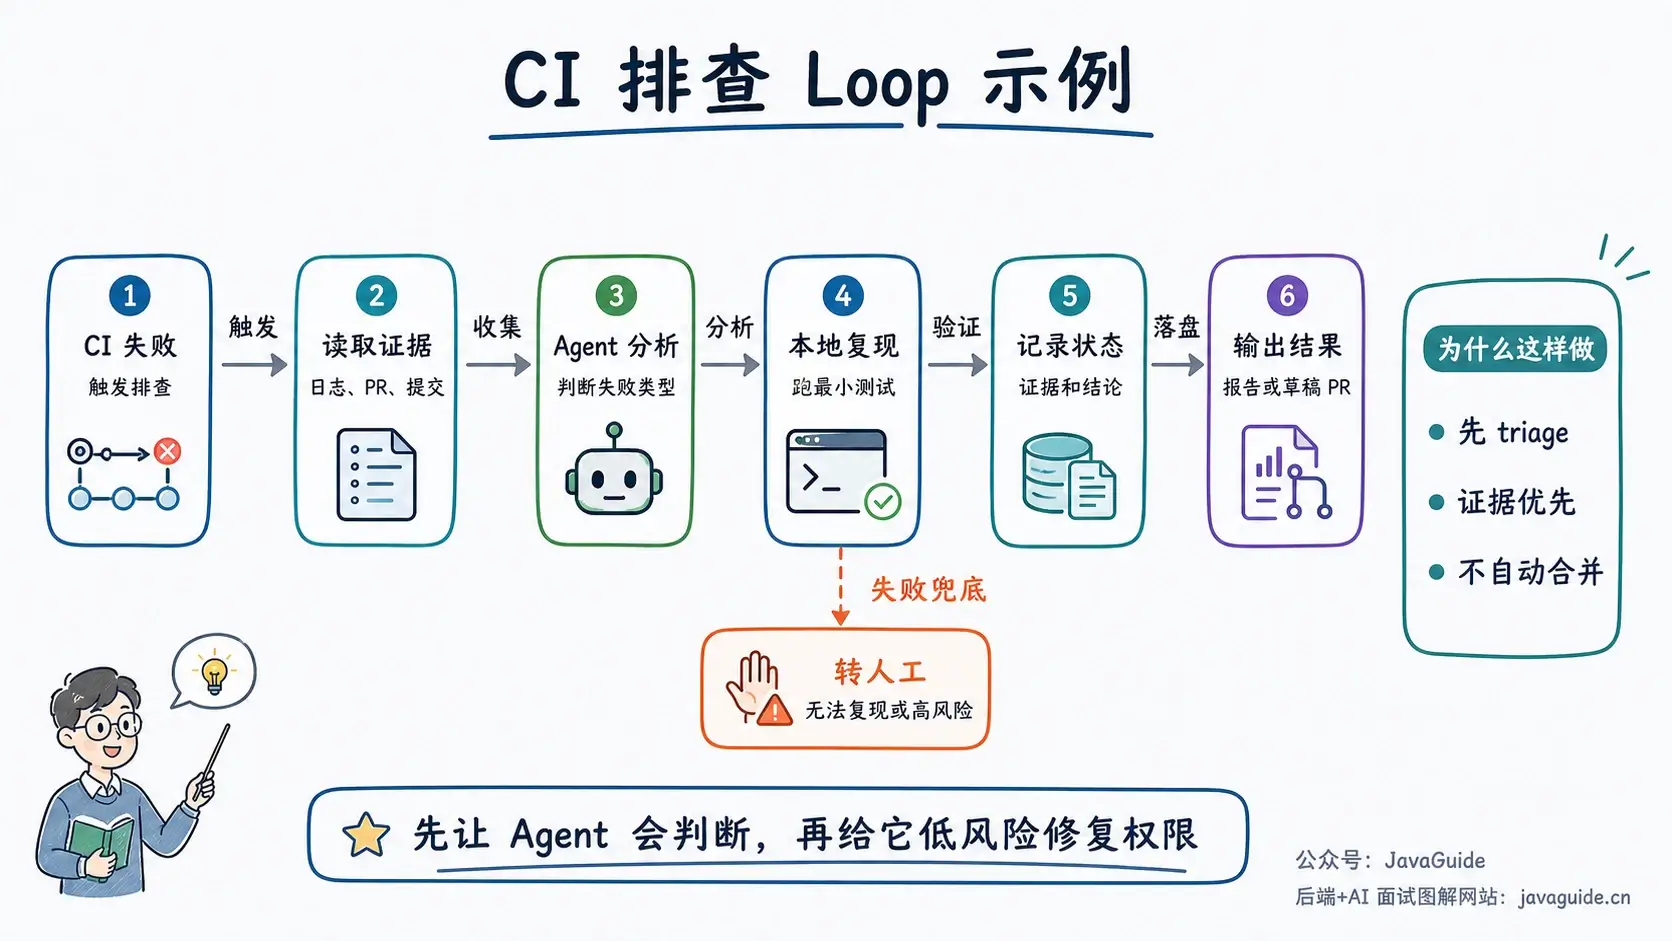
等排查摘要已经能稳定对应到失败用例,再考虑开放修复。例如格式规则已经确定,可以在独立 worktree 中修正并运行目标测试。依赖升级和快照更新则要另外核对兼容性、预期行为,不能因为改动看起来短就一并放行。
这一版修复成功后只创建 PR,交给人合并。可以让另一个 Agent 根据项目 Skill 和 diff 先检查一遍,但它的通过意见不能代替测试结果。不确定或验证失败的项,保留在人工队列里。
这个 Loop 里能看到前面提到的几个部件:
| 部件 | 在这个例子里做什么 |
|---|---|
| Automation | 每天或 CI 失败时启动 |
| Skill | 固化 CI 排查流程、测试命令、仓库规则 |
| MCP / Connector | 读取 GitHub、CI、Issue、日志平台 |
| Context Engineering | 只加载失败相关日志、文件和规则 |
| Worktree | 隔离自动修复分支,避免污染主工作区 |
| Sub-agent | 一个负责实现,一个负责验证 |
| Memory / State | 记录已尝试方案、失败原因和下一步 |
| Stop Condition | 测试通过、达到重试上限、遇到高风险操作 |
再次运行时,还要检查这项失败有没有被别的任务处理。如果开发者已经修好,并且对应提交通过了 CI,就更新处理状态,避免按旧日志再修一次。
什么场景值得做 Loop?
CommonJS 到 ESM 迁移适合分批修改:本轮改过的文件能运行构建检查,剩余的旧引用留给下一轮。依赖升级也能比较升级前后的测试与 build 输出。这类任务有可以重复执行的检查,比较容易决定是否继续。
补测试要多看一步。覆盖率从 62% 涨到 75%,只能说明更多代码被执行过;新增用例如果没有检查返回值,关键行为还是没验证到。因此需要同时审查断言。Anthropic 的 Agent 评测文章区分了 Agent 的完成声明和环境中的实际结果,放到这里,就是不能只接受一句“已补齐测试”。
文档同步也可以循环处理,但验收对象是文档里的内容。对照代码 diff,检查新增接口是否写对、删除的配置是否仍在说明中,比只判断文件有没有生成更有用。
PR / Issue 分拣可以停在分类、摘要和优先级建议这一步。要修改负责人或发通知,再开放相应权限。生产数据库、权限系统、支付链路的变更则需要单独审批和恢复方案,不适合套用普通代码修复的放行条件。
品牌文案和增长策略最后通常要由人选择。可以让 Agent 准备约定数量的候选和评审材料,准备好就停,不必让它反复判断哪一版“足够好”。老代码项目如果缺少故障复现条件,也先补日志、测试和回滚方式,再开放自动修改。
最容易踩的坑
目标写得太虚
这条目标没有说明要改哪里,也没说明完成以后怎样检查:
/goal "优化这个项目,让代码质量更好"如果实际问题只是 auth 模块的测试失败,就把目标限定到这里:
/goal "auth 模块失败的单元测试全部通过,只允许修改 src/auth 和 tests/auth;每轮修改后运行 npm test -- tests/auth 并展示退出码;最多 5 轮;如果连续 2 次失败原因相同,停止并汇报"修改完以后,先查 diff 有没有超出 src/auth 和 tests/auth,再查 npm test -- tests/auth 的输出及退出码。范围和验证方式都有了,才知道 Agent 做的是不是这项任务。“最多 5 轮”若要求严格执行,仍需由执行器计数,不能只依赖目标中的文字。
至于“连续两次失败原因相同”,模型可能对同一种错误给出不同总结。程序需要比较时,应先归一化失败测试和错误类型,再作判断。
把 Agent 自评当验收
审核 auth 修复时,先看实际测试输出,而不是完成摘要中的“已修复”。如果改动还涉及界面或业务含义,再看截图和审查意见。让另一个 Agent 在独立上下文里复核可以多一道检查,但它也需要需求和执行结果作为依据,涉及生产的操作仍保留项目要求的人工审批。
忘了成本上限
“最多 5 轮”只限制了循环次数,一轮仍可能读取大量文件或发起多次工具调用。因此还要分别设置最大工具调用次数、单任务或单日的 Token / 金额预算,达到任一上限就停止。
预算未耗尽也可能需要提前结束。连续两轮仍是同一个失败测试、同一类错误,且没有取得新证据时,应保留当前 diff 和日志,汇报未解决的问题。低价值任务可以只输出摘要,省去自动修复和复验的成本。
权限给得太大
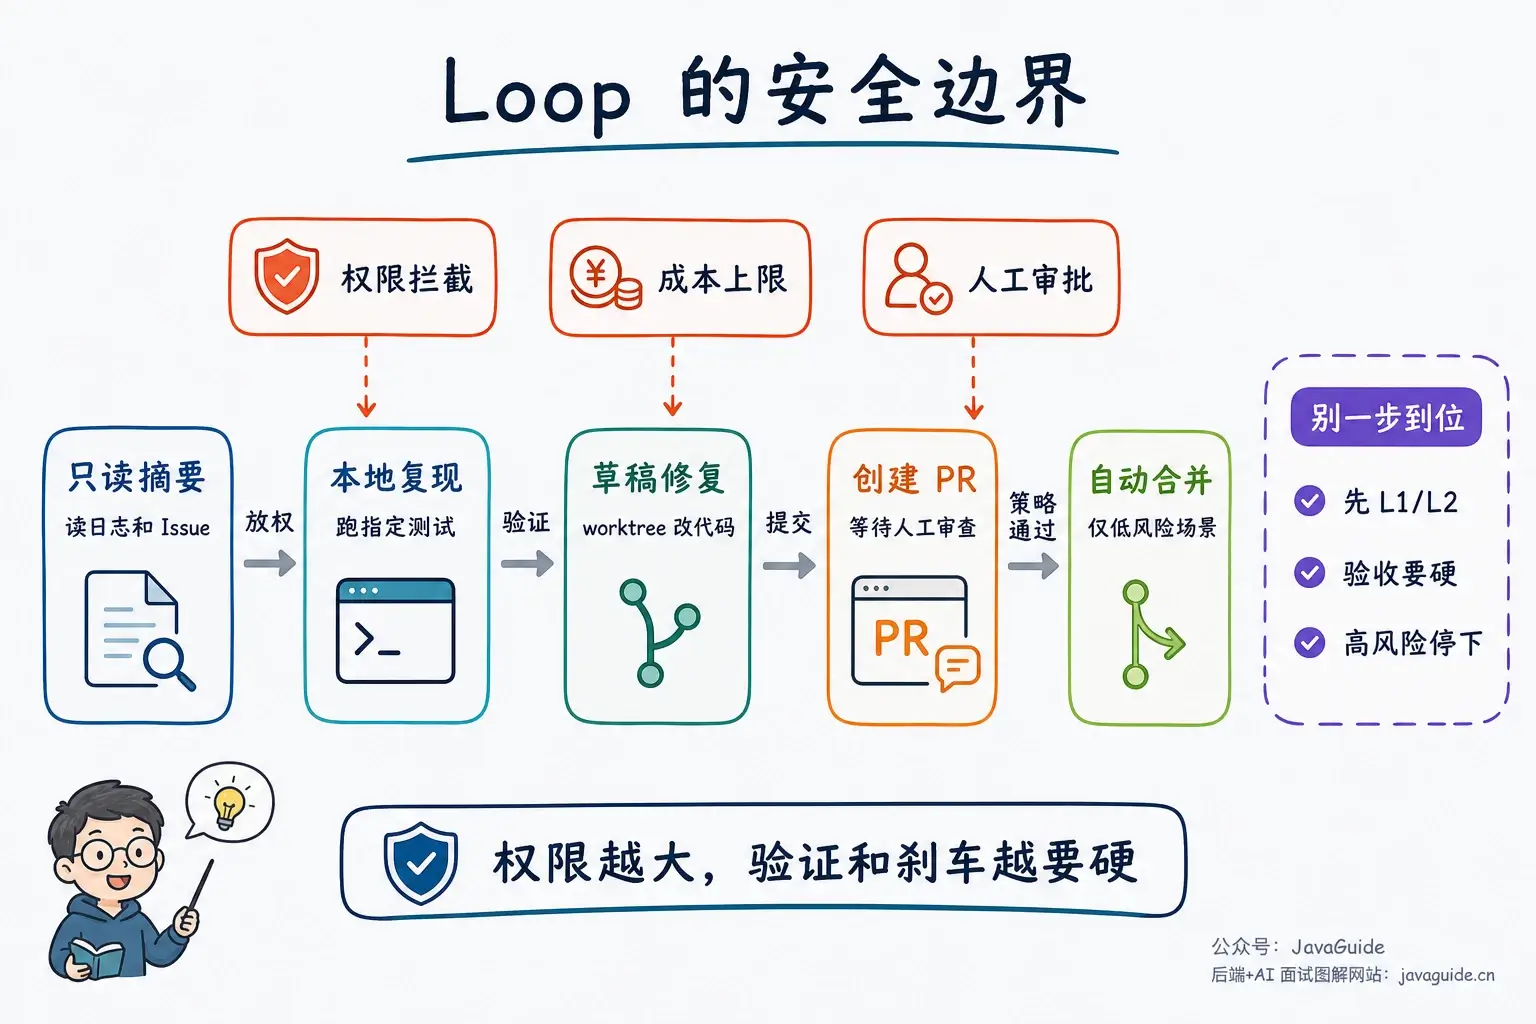
读日志只获取信息,开 PR 会写入远端,合并则会改变目标分支。本文的 CI 排查方案按阶段开放权限;删除文件、修改生产配置、发送外部消息或写业务数据库,如果没有预先明确授权,就停下来确认。具体审批策略由项目决定,不能把所有任务统一设成“自动通过”。
MCP Server 的来源、工具 description、返回内容和 Prompt 模板也要进入审核范围,因为这些内容都可能携带提示词注入。权限可以按执行阶段逐级开放:
| 阶段 | Agent 能做什么 | 人负责什么 |
|---|---|---|
| L0 只读摘要 | 读日志、读 Issue、生成报告 | 判断是否采纳 |
| L1 本地复现 | 运行指定测试、定位失败 | 决定是否修复 |
| L2 草稿修复 | 在 worktree 里改代码、跑测试 | Review diff |
| L3 创建 PR | 提交分支、写 PR 描述 | 审查、合并 |
| L4 自动合并 | 通过策略后自动合并 | 只处理异常 |
表里的 L1 只运行指定测试,L2 才允许改代码,可以分开开放。L4 的前提更严格:问题类型固定,主要风险有测试覆盖,回滚也经过验证,而且运行后仍需审计。业务判断、权限变更和数据写入继续保留人工审批,不属于“测试绿了就合并”的范围。
第一版先别急着自动修
第一版只做排查,允许更新 TODO.md 和运行指定测试,不允许改业务代码、发外部消息。注意,这已经包含写文件,不能按严格只读任务配置。测试命令要事先确认使用测试环境。
任务:每天看最近 24 小时的 CI 失败,产出排查摘要,供人处理。

允许做:
- 读 GitHub Actions、最近提交、失败测试日志,以及和报错直接相关的文件。
- 定位到具体测试时,可以跑对应测试确认是否复现。
- 把结论写进 TODO.md,带上 CI 链接、关键错误和建议负责人。

开始前:
- 先读取 AGENTS.md。
- 命中 CI 排查任务时加载 ci-triage Skill。

不允许做:
- 不改代码,不创建 PR,不发 Slack/邮件。
- 不读取整仓无关文件,不粘贴完整日志。
- 超过 10 个失败项就停;单个失败最多复现 2 次。
- 权限不足、日志缺失、需要业务判断时,直接标记人工处理。
先运行这份任务,再看实际记录:有没有读取无关目录,已经复现的测试是否反复执行,是否试图发送消息。任务描述写得清楚,还需要用执行记录确认它有没有照做。发现这些问题时,先调整权限和步骤,再考虑让它修代码。
一次本地复现后,可以按下面的 YAML 保存状态。evidence 用来找到 CI 记录,action 和 result 记录这次执行,next_step 留给后续处理。这里的 max_attempts: 3 限制整项排查的轮次;单个失败项最多复现 2 次,是上面任务描述中的另一项限制,计数不能因进入下一轮而重置。
loop_id: ci-triage-2026-06-17
goal: "排查最近 24 小时 CI 失败"
status: running
scope:
  repos: ["backend-service"]
  max_items: 10
attempts:
  - item: "auth-test failure"
    evidence: "GitHub Actions run #12345"
    action: "ran npm test -- tests/auth"
    result: "reproduced locally"
next_step: "ask auth owner to review"
stop_condition:
  max_attempts: 3
  require_human_when:
    ["permission_missing", "production_change", "uncertain_root_cause"]
以后开放自动修复,可以在这份记录中补上 diff 和验证结果。不过旧记录中的 reproduced locally 只说明复现过故障,不能拿它作为修复后的验证结果。每次修改之后,都要记录新的验证。
把 Loop 接入生产流程前
什么会触发下一轮?
同一项 CI 失败可能刚触发一次事件任务,又被上午 9 点的定时任务扫到。入口可以不同,处理记录要使用一致的标识,例如仓库、提交和失败项的组合。需要并发领取任务时,靠数据库唯一约束或原子更新防止重复领取,仅让两个 Agent 各自“先查一下”仍有竞态。
什么时候继续,什么时候停?
attempts 中已经有相同命令和失败结果时,先看这一轮是否改变了测试输入或待验证的假设。什么都没变,再跑一次通常也解释不了原因。达到 stop_condition 则保存记录并交接,任务尚未完成也不能越过上限。
Coding Agent 反复修不好,下一轮还要继续吗?
先比较失败证据有没有变化。修改了更多文件,并不代表更接近问题原因。假设 Agent 要修复订单金额计算错误,连续两轮只调整展示文案,原先失败的金额断言始终未变。第三轮如果仍围绕文案修改,就没有新的排查依据。
每轮保留失败用例、实际与预期结果、相关 diff,以及本轮想验证的原因。下一轮先回答:这次改动是否作用于失败路径?错误是否消失或发生了可解释的变化?有没有新增回归?测试通过是否只是因为删除或放宽了断言?
日志已经指向税费计算,就该去查计算条件,继续改展示文案没有帮助。如果上一轮还引入了回归,可以撤回那一轮能够确认归属的改动。共享工作区尤其要先看 diff,不能为了回退一次失败尝试,把用户或其他任务的修改一起撤掉。
到这里仍无法复现,或缺少核对金额规则的资料,就把失败用例、尝试记录和缺少的信息交出去。下一轮拿到新资料再继续。只是换一种措辞重发原来的目标,并没有增加排查依据;预算耗尽时也必须停。
总结
第一次接入 Loop,可以先让同一个排查任务运行两次。观察第二次是否读到了旧记录、是否跳过已经处理的失败项,比只确认定时器能启动任务更有用。
等这部分可靠了,再按需要开放自动修复。每轮留下的 diff、验证结果和未完成事项,也正是开发者接手时需要查看的材料。