知识库问答能返回一段通顺的文字,怎样判断它答得好不好?资料有没有找到,回答有没有依据,资料不足时会不会编造,这些都需要检查。
本文从一条知识库问答开始,介绍如何准备评测样本、分别检查检索与生成,以及怎样用评测结果指导优化。还不熟悉问答流程的话,可以先看 RAG 基础概念。
什么是 RAG 评测?
RAG 评测,就是按照预先确定的标准,检查检索增强生成系统的表现。 除了最终回答,还要检查检索结果和请求执行过程。
2026/10/25大约 16 分钟
知识库问答能返回一段通顺的文字,怎样判断它答得好不好?资料有没有找到,回答有没有依据,资料不足时会不会编造,这些都需要检查。
本文从一条知识库问答开始,介绍如何准备评测样本、分别检查检索与生成,以及怎样用评测结果指导优化。还不熟悉问答流程的话,可以先看 RAG 基础概念。
RAG 评测,就是按照预先确定的标准,检查检索增强生成系统的表现。 除了最终回答,还要检查检索结果和请求执行过程。
接口返回 200,耗时也正常,智能客服给出的退款规则却是错的。
打开监控面板,只能看到这次请求调用过大模型,并且正常生成了回答。再往下查就麻烦了:是知识库没有召回正确资料,Prompt 拼错了,模型忽略了上下文,还是某个工具返回了旧数据?普通接口日志通常回答不了这些问题。
一次 AI 请求可能会经过问题改写、知识库检索、重排、模型调用、工具调用和结果校验。Agent 还可能重复执行其中几步。每一步看起来都调用成功,错误结果却会继续传给下一步,最后得到一段格式正常、内容有问题的回答。
排查时需要顺着这条执行过程往回找:当时用了哪个模型和 Prompt,检索到了哪些文档,调用了什么工具,Agent 重试了几次,最终回答参考了哪些结果。
Loop Engineering 这个名字容易让人以为又出现了一种新的 Agent 架构。拆开来看,它用到的调度、循环、状态保存,在 CI 和工作流系统中都能找到。变化在于,现在可以让 Agent 参与其中,自己读日志、定位文件,再尝试修改。
不过,把 Agent 设成每隔几分钟运行一次,还没有解决任务衔接的问题。下一次运行能不能接着上一次继续,取决于程序怎样保存和读取结果。
它讨论的是 Agent 多轮任务的执行安排。 Claude 团队的 Getting started with loops(2026 年 6 月 30 日)按触发方式和停止条件介绍了不同做法。具体到项目,不一定要另装一个“Loop 框架”,已有的 CI 或调度程序也可以完成这部分工作。
前段时间有读者朋友想让我聊聊 LLM 网关:它到底解决什么问题,什么时候值得单独部署,又该怎么选型。
于是,我把自己做项目时的实践和思考整理成了这篇详细介绍,内容有点干,算上极少的代码的话,有 3w+ 字了。
先说结论:对大多数单体或单团队项目来说,自己在应用内写一个轻量 LLM 网关就够了。先把分散在各个业务模块中的模型调用集中到一个统一入口,再按需补上超时、重试、日志和简单路由。通常没必要专门引入 LiteLLM、Kong AI Gateway 这类额外组件,更没必要一开始就搭一套独立的网关平台。
意图分类、标题生成、JSON 修复和复杂报告生成如果全部调用同一个旗舰模型,早期开发确实省事。流量上来后,成本、延迟和供应商限流会一起暴露:轻量任务占用昂贵模型的配额,关键任务失败时又没有备用链路,月底账单还无法归因到具体租户和功能。
客服 RAG 换了混合检索,又加上 Reranker,本地挑几十条问题试过,答案读起来比旧版顺。凭这些结果,能不能放量?
假设一周后收到反馈:“有些问题还不如以前准。”要判断这句话,就得找出旧版在同一批问题上的结果。退换货的政策有没有召回,物流查询有没有答对,商品参数比较有没有漏项,都要分别对照。没有历史记录,只能重翻原始对话,还未必能还原当时的知识库和 Prompt。
评测集要把这份比较依据留下来。换模型、改 Prompt、调检索策略之后,用相同输入和评分标准检查变化,才知道哪些场景改善了,哪些需要继续排查。
RAGAS、TruLens、LangSmith、Langfuse 等框架仍在持续演进,生产接入应以各自的最新官方文档为准。本文只讨论评测方法和指标设计,不做工具横向测评,也不引用未经验证的 benchmark 数字。
假设用户提交问题后等了 8 秒,页面还没有内容,于是刷新重试。此时后端需要判断:旧请求仍在生成,还是已经中断?新请求应订阅旧任务,还是创建一次新的模型调用?如果直接再调一次供应商 API,就可能产生两份结果和两笔费用。
即使已经收到响应,也不能马上标记成功。{"answer": "根因是 这样的半截 JSON 还不能交给下游;供应商返回 429 时,立即重试又可能加剧限流。调用链需要保存生成状态,并把取消、重试、配额与结果校验接到这些状态上。
阅读这条调用链需要了解 Token、上下文窗口、Temperature、Top-p 等基础概念。如果还有疑问,建议先看《LLM 运行机制:Token、上下文窗口与采样参数怎么影响输出》和《大模型提示词工程(Prompt Engineering)是什么?提示词技巧有哪些?》。
工单分类接口约定 priority 只能取几个枚举值,confidence 必须是数字。模型返回的对象即使能被 JSON 解析器读入,也可能在这两项上不符合要求;响应前面若多了“好的,以下是结果”,还会更早地卡在解析阶段。
后端需要分别回答两个问题:这份数据符合字段契约吗?如果它表示一次工具调用,当前用户有权执行吗?前者可以用 Schema 约束并校验,后者要交给可信执行层检查。
JSON Mode、Structured Outputs、MCP 与 Java 服务端分别处在这条调用链的不同位置。
接入 OpenAI、Anthropic、Gemini 或 MCP 时,要核对目标模型和协议版本支持的能力。同一份 Schema 不一定能直接用于所有供应商。
“这几个部门过去半年反复提到的风险点是什么,它们之间有什么关联?”这类问题需要跨文档汇总部门、风险、项目、供应商和时间信息。Top-K 向量检索可以找出相似片段,但不会自动保存这些对象之间的关系。
GraphRAG 在检索链路中加入图结构,用实体、关系或主题摘要组织跨文档证据。是否值得引入,要看现有 RAG 的失败样本是否集中在多跳关系和全局归纳上。

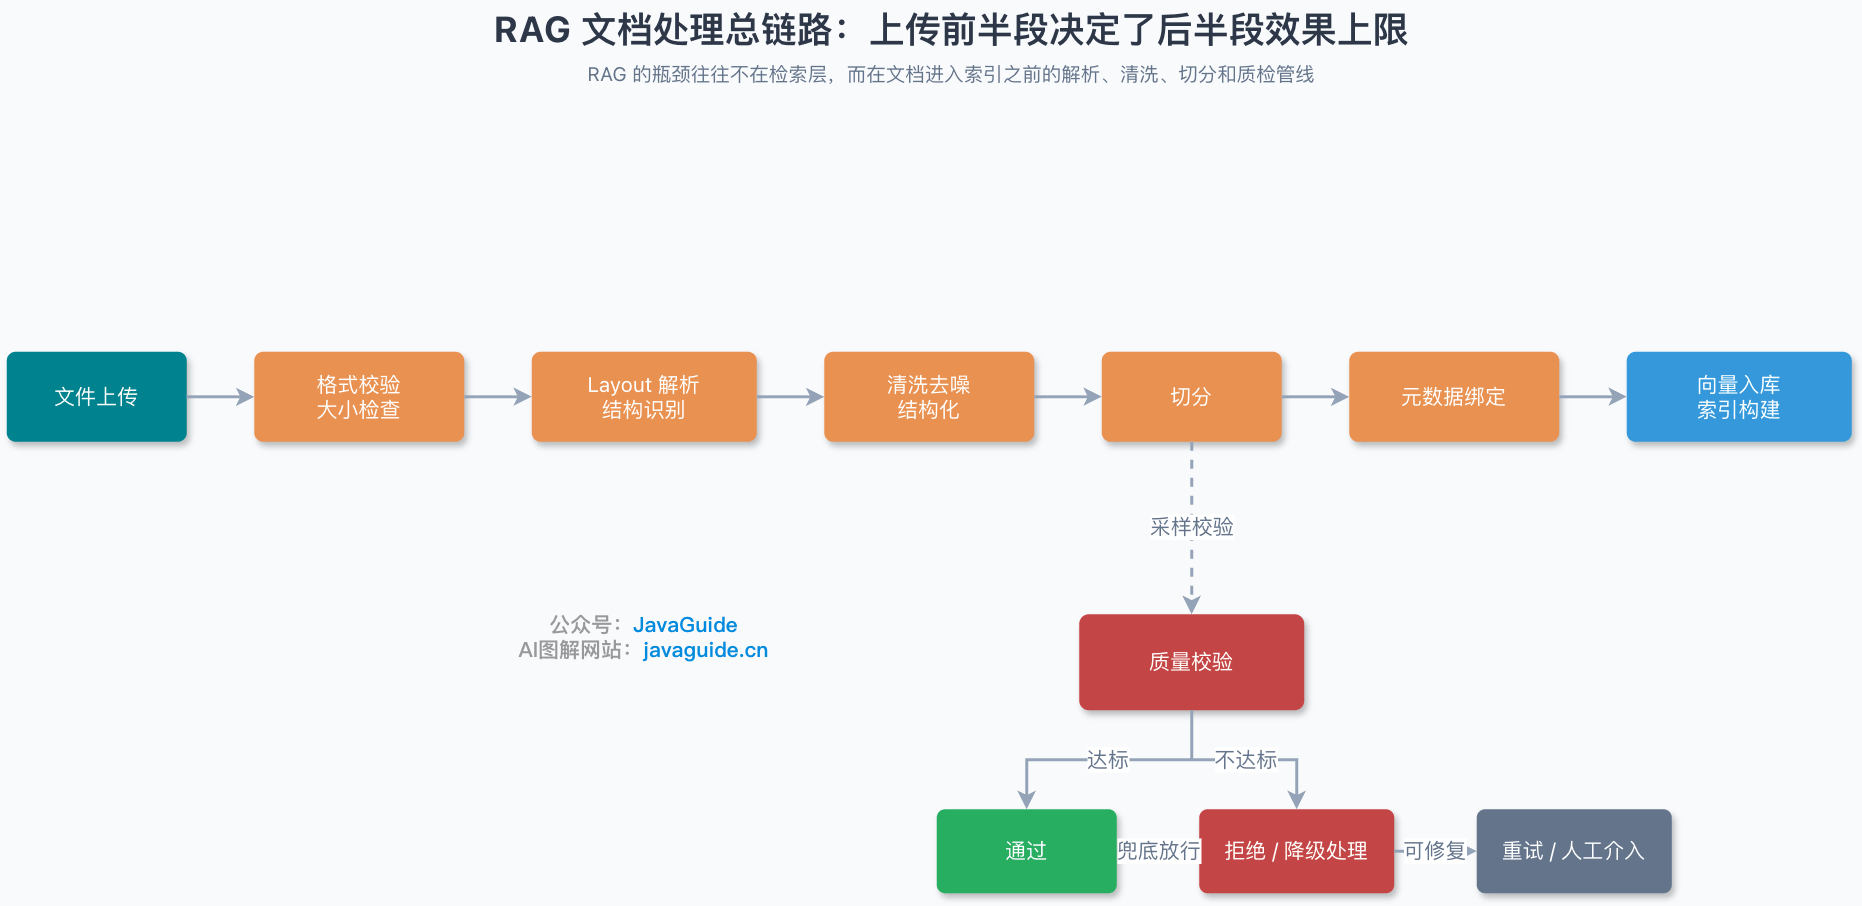
RAG 检索前要先把 PDF、Word、Excel 或扫描件转换成可检索内容。多栏 PDF 的阅读顺序、表格的行列关系、标题层级和 OCR 错误如果在这一步处理错了,后续更换 Embedding 模型或向量数据库也无法恢复丢失的信息。
本文按文档从上传、解析、切分、校验到多模态入库的顺序,说明各环节的工程做法与边界。
文档从上传到进入向量库,中间至少要经过六个环节:
第一个企业知识库 RAG 系统上线后,很多团队都会碰到一个很真实的问题:文档明明更新了,回答还是老样子。
这时候先别急着怪 LLM。更常见的原因是知识库没有同步更新,或者更新链路只做了“写入新内容”,没有处理旧版本、权限、索引一致性这些细节。
文档变更频繁之后,问题会更明显:每次都全量重建索引,成本和耗时扛不住;只更新变化部分,又怕漏掉旧块;只插入新向量,不清理旧版本,过期内容还会继续被召回;换了 Embedding 模型,历史数据到底要不要全部重索引,也绕不开。
知识库更新要同时处理版本、权限和多个索引之间的一致性。本文沿着新增、修改、删除三类事件,说明增量同步、全量重建、灰度、回滚和监控怎么配合。